7 Alternatives à Bright Data pour le scraping web et les données d'entreprise (2026)
Bright Data commercialise plusieurs produits : proxys, API d'accès, API de scraping, navigateurs et jeux de données. Une bonne alternative à l'un ne l'est pas automatiquement pour les autres. Ce guide se concentre sur la collecte de données web et d'entreprise, avec l'API Web Scraper comme référence tarifaire.
Réponse rapide
Pour une API de scraping managée, comparez Oxylabs et Zyte API sur la source exacte et le mode de rendu dont vous avez besoin. ScrapingBee convient à un endpoint configurable au sein d'un pipeline que vous possédez déjà.
Pour des scrapers prêts à l'emploi ou des tâches hébergées personnalisées, consultez Apify. Pour du code de crawler que vous exploitez vous-même, envisagez Crawlee.
Pour des listes d'entreprises locales, Outscraper convient aux exports Maps occasionnels ; OwnerClue convient à la recherche des agences avec des observations de sites web et des contacts sourcés. Ils ne remplacent pas un réseau de proxys général ni une API de navigateur.
Conservez Bright Data lorsque son scraper maintenu, son format de livraison ou son infrastructure plus large répond déjà à votre besoin. Son API Web Scraper affiche également un niveau gratuit mensuel de 5000 enregistrements.
Quelle Bright Data alternative correspond à votre tâche ?
3 questions rapides · facultatifComment nous avons comparé ces alternatives
Nous avons vérifié les pages produit officielles, la documentation et les tarifs pour le travail que chaque outil peut prendre en charge, le coût de démarrage, les limites gratuites ou d'essai, et ce que vous devriez reconstruire. Les prix ont été vérifiés le October 12, 2026.
OwnerClue publie ce guide et est inclus ci-dessous. Il s'agit d'une comparaison basée sur la documentation, et non d'un benchmark de performance. Les captures de sites web identifient les produits et les conditions des offres ; les démonstrations officielles et l'espace de travail expurgé sont étiquetés dans leurs légendes.
| Ce que nous avons comparé | Pourquoi c'est important |
|---|---|
| Produit et résultat | Proxys, contenu de pages, enregistrements analysés et jeux de données précollectés sont des livrables différents. |
| Cible et champs exacts | Un scraper de source maintenu et une requête sur domaine personnalisé peuvent avoir des schémas et des tarifs différents. |
| Rendu et parsing | JavaScript, interaction, options d'extraction et niveaux de cibles modifient le coût du résultat exploitable. |
| Responsabilité du pipeline | Quelqu'un doit toujours prendre en charge la découverte, la planification, le mapping des champs et la surveillance des données manquantes. |
Sur cette page
Why look for alternatives to Bright Data?
Commencez par identifier le produit Bright Data que vous souhaitez remplacer. Un proxy achemine le trafic ; une API de récupération renvoie le contenu des pages ; un scraper maintenu renvoie des champs structurés ; un jeu de données fournit une collection existante. Ces résultats impliquent des coûts et des responsabilités différents.
Un scraper de sources prises en charge est la comparaison la plus proche lorsque votre application attend un schéma stable de produit, de profil ou d'annonce. Vérifiez les champs spécifiques, les variantes de sources, la fraîcheur et le mode de livraison. Une réponse HTML moins chère n'est pas équivalente si votre équipe doit maintenir le parsing.
Un service de récupération est pertinent lorsque vous contrôlez déjà la file d'URL et le code d'extraction. Comparez la prise en charge de JavaScript, les paramètres de requête, les formats de réponse et l'impact de l'extraction optionnelle sur la facture.
Un outil de recherche d'entreprises est une option plus restreinte lorsque l'objectif final est une liste de prospects locaux vérifiée. Il peut supprimer une partie du travail d'assemblage pour cette tâche, sans toucher à l'infrastructure de collecte plus large. Ne migrez pas un pipeline de surveillance des prix ni un workflow de navigateur personnalisé vers un outil conçu pour les prospects locaux.
The 7 Bright Data alternatives
Ces outils prennent en charge différentes parties du travail. Chacun utilise le même format de fiche rapide, suivi d'un cas d'usage pratique et d'une limitation qui pourrait changer votre choix.
1. Oxylabs: Pour une API de scraping gérée
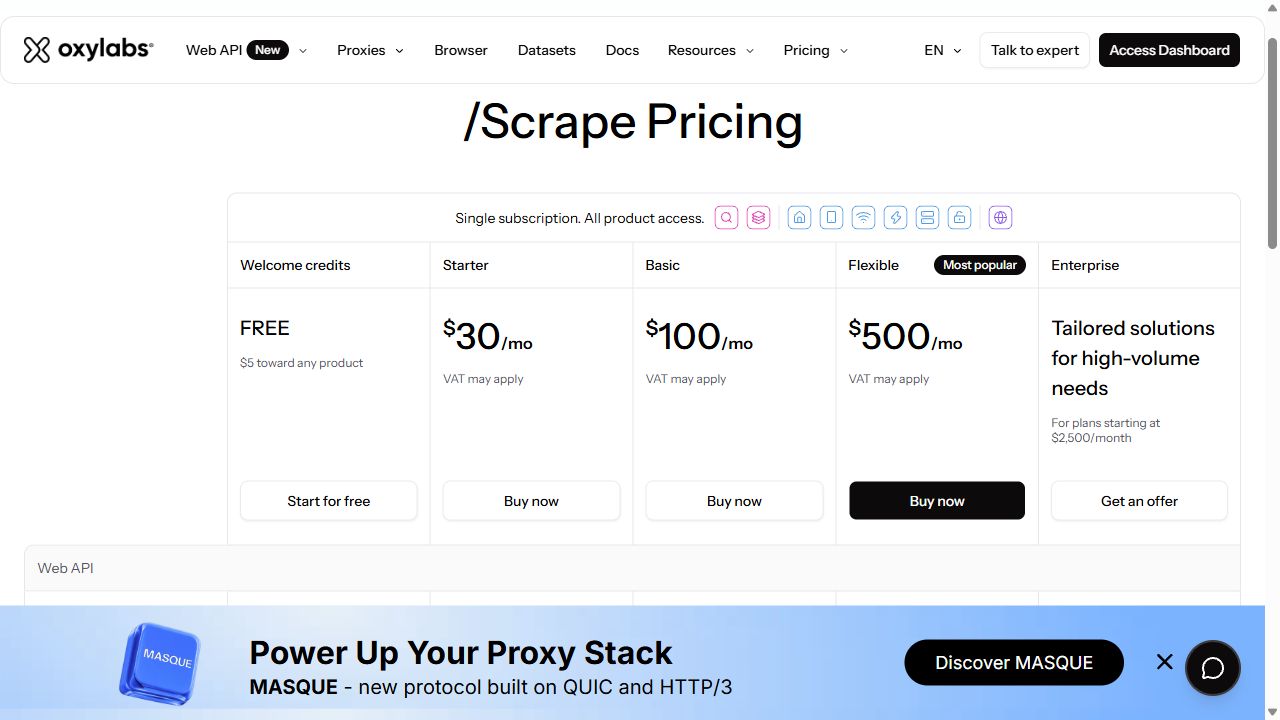
| Prix | Starter $30 / moisAbonnement actuel Web API /Scrape. Domaines personnalisés : $1 / 1000 résultats non-JS ou $1.50 / 1000 résultats JS aux tarifs Starter |
|---|---|
| Idéal pour | Développeurs ayant besoin d'une récupération gérée et de points de terminaison de scraping spécifiques à une source. |
| Limites de l’offre gratuite / d’essai | $5 crédits de bienvenue pour les produits · pas un quota récurrent |
| Fonctionnalité clé | Web API /Scrape avec options de récupération et d'analyse propres à chaque cible. |
| Principale limite | La source, le rendu et l'analyse IA modifient le tarif ; le tarif le plus bas annoncé n'est pas un prix universel. |
Oxylabs est un candidat direct pertinent pour la partie scraping géré de Bright Data. Son ancienne URL de tarification de l'API Web Scraper redirige désormais vers Web API /Scrape, avec un abonnement partagé et des tarifs propres à chaque cible.
Pour un domaine personnalisé, le tableau Starter indique des tarifs distincts pour JavaScript et non-JavaScript. Amazon, Google et d'autres cibles ont leurs propres lignes, et l'analyse IA est facturée séparément.
Comparez le point de terminaison et le schéma renvoyé dont votre pipeline a réellement besoin. N'utilisez pas le tarif Amazon le plus bas pour estimer un site personnalisé rendu par navigateur. Un essai doit inclure vos pages difficiles autant que vos pages faciles.
Un candidat proche pour une collecte pilotée par API. Tarifiez la source exacte, le mode de rendu et la configuration d'analyse.
2. Zyte API: Pour une récupération de sites web à l'usage
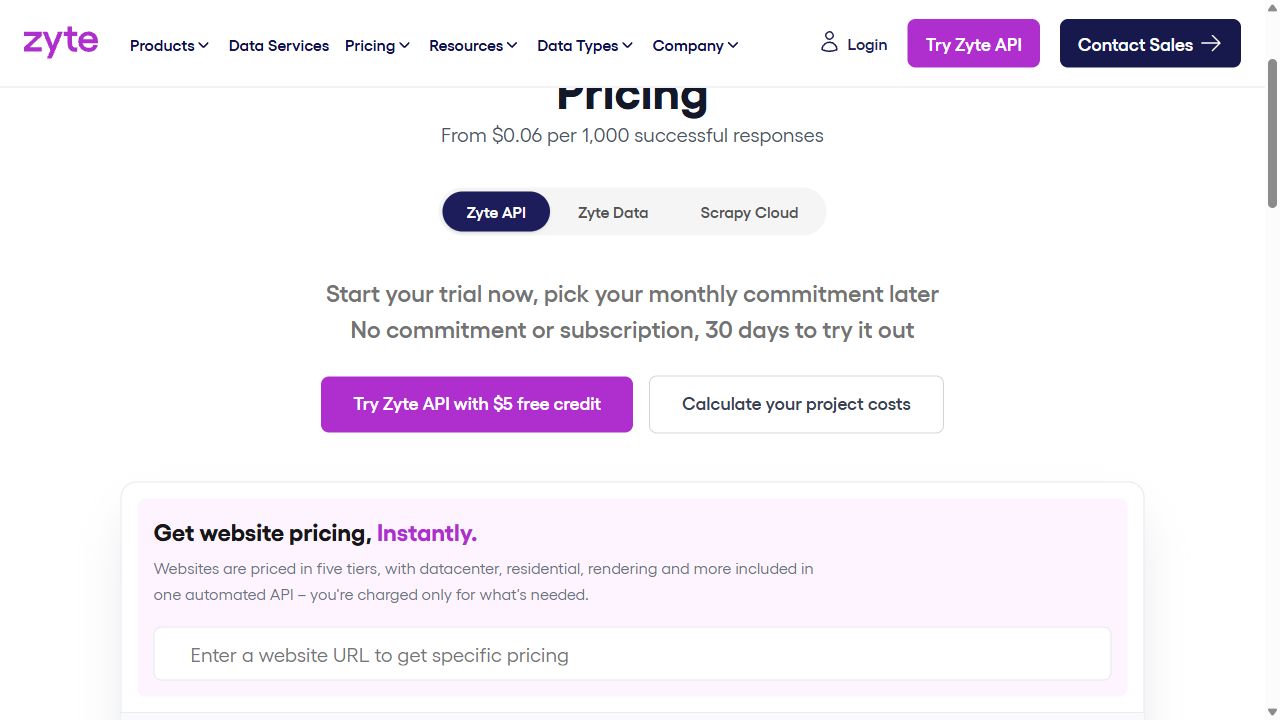
| Prix | PAYG HTTP $0.13–$1.27 / 1000PAYG rendu par navigateur $1.01–$16.08 / 1000 ; le niveau du site et les fonctionnalités supplémentaires influent sur le coût |
|---|---|
| Idéal pour | Développeurs souhaitant un accès géré tout en conservant leur pipeline de crawling. |
| Limites de l’offre gratuite / d’essai | $5 de crédit · évaluation de 30 jours |
| Fonctionnalité clé | Récupération gérée et rendu par navigateur avec options d'extraction automatique. |
| Principale limite | Les coûts HTTP, navigateur et extraction diffèrent ; le minimum affiché suppose un engagement. |
Zyte API est utile lorsque vous souhaitez conserver la file d'URL et le pipeline en aval tout en déléguant la récupération et le rendu à un service géré. Ses requêtes HTTP et navigateur ont des prix différents, et le site cible détermine le niveau.
Cela compte pour un crawl mixte : un article statique facile et une page produit rendue difficile ne doivent pas recevoir la même estimation de coût. L'extraction automatique et d'autres options peuvent ajouter des frais.
Le tarif le plus bas affiché sur la page de tarification appartient à un forfait avec engagement. Le tableau ici utilise des fourchettes à l'usage afin que la comparaison ne suppose pas un engagement mensuel que vous n'avez pas choisi.
Envisagez-le pour un pipeline que vos développeurs contrôlent déjà. Estimez les coûts avec des URL représentatives et les mêmes paramètres d'extraction.
3. ScrapingBee: Pour un point de terminaison de scraping configurable
| Prix | Freelance 49 $ / mois250000 crédits API et 50 requêtes simultanées actuellement indiqués |
|---|---|
| Idéal pour | Développeurs qui récupèrent des pages et extraient des champs sélectionnés dans une application existante. |
| Limites de l’offre gratuite / d’essai | 1000 crédits API d'essai · aucune carte requise |
| Fonctionnalité clé | Récupération de pages, scénarios JavaScript et extraction CSS/XPath ou par IA. |
| Principale limite | Une requête peut consommer plusieurs crédits selon le rendu, le proxy et les options d'extraction. |
ScrapingBee convient à un développeur qui souhaite demander une URL et choisir la façon dont elle est récupérée ou extraite. Ses options documentées incluent les interactions JavaScript, l'extraction par sélecteurs et l'extraction par IA.
Pour un suivi de prix, commencez par la configuration la plus simple qui renvoie les champs requis. N'ajoutez le rendu ou l'interaction que lorsque la source l'exige, puis vérifiez les crédits consommés par page réussie.
La carte Freelance actuelle indique 250000 crédits. Il s'agit d'un budget de crédits, et non de la promesse de 250000 pages rendues ou de fiches produit complètes. Votre application doit toujours planifier les requêtes, mapper les sorties et surveiller les champs manquants.
Un point de terminaison pratique pour un pipeline que vous maîtrisez. Comparez les crédits par sortie exploitable, et non les seuls crédits annoncés.
4. Apify: Pour des scrapers prêts à l’emploi et des tâches cloud personnalisées
| Prix | Starter 19 $ / mois + consommation19 $ de consommation prépayée ; les frais d’Actor et de plateforme sont déduits de ce crédit |
|---|---|
| Idéal pour | Équipes combinant des scrapers pris en charge avec des API, des planifications ou du code personnalisé. |
| Limites de l’offre gratuite / d’essai | 5 $ de consommation chaque mois · aucune carte requise |
| Fonctionnalité clé | Une place de marché d’Actors et un environnement d’exécution hébergé pour l’extraction et l’automatisation. |
| Principale limite | Les entrées, sorties, prix et maintenance des Actors varient selon le développeur. |
Apify est un candidat utile lorsqu'un Actor prêt à l'emploi couvre votre source ou lorsque vous avez besoin d'une logique personnalisée autour de la collecte. Son environnement d'exécution hébergé, ses planifications, ses jeux de données et ses API conviennent à une tâche en plusieurs étapes comportant plus d'une étape d'extraction.
Pour un détaillant qui suit un ensemble défini d'URL de produits, examinez le prix, la disponibilité, les identifiants et les horodatages de l'Actor sélectionné. Deux Actors pour le même site peuvent différer par les champs, la maintenance et la facturation.
Il s'agit d'un choix de plateforme et d'Actor plutôt que d'un remplacement direct de proxy. Incluez les frais d'événement ou d'usage de l'Actor et toute consommation supplémentaire de la plateforme. Exécutez un petit échantillon avant d'estimer le coût mensuel du pipeline.
Choisissez-le lorsqu'un Actor vérifié ou un programme hébergé personnalisé est le facteur décisif. Comparez sa sortie complète et sa facturation avec le scraper Bright Data actuel.
5. Crawlee: Pour un crawler que votre équipe maîtrise
| Prix | Logiciel libre et open sourceL'hébergement, les proxys, le stockage et l'ingénierie sont des coûts supplémentaires |
|---|---|
| Idéal pour | Développeurs qui construiront et exploiteront leur propre code d'extraction. |
| Limites de l’offre gratuite / d’essai | La bibliothèque n'a pas de frais d'abonnement logiciel |
| Fonctionnalité clé | Crawling open source en JavaScript et Python, avec une infrastructure que vous gérez. |
| Principale limite | Votre équipe assure l'exécution, la surveillance, l'infrastructure et la maintenance. |
Crawlee est l'option lorsque le contrôle du code d'extraction compte plus que l'achat d'un service de données maintenu. C'est une bibliothèque de crawling open source d'Apify, avec des points d'entrée JavaScript et Python.
Pour une équipe qui collecte un ensemble évolutif de sources de recherche internes, maîtriser la file de requêtes et le code d'analyse peut être utile. Mais cette équipe assure aussi l'exécution, le stockage, les planifications, la surveillance et la maintenance lorsqu'un site change.
Crawlee n'inclut pas de réseau de proxys ni de remplacement prêt à l'emploi des schémas de sources de Bright Data. Vous pouvez toujours utiliser un service de récupération ou de proxy géré en dessous. Budgétez l'infrastructure et l'ingénierie avant de considérer l'absence de frais logiciels comme un coût total inférieur.
Envisagez-le lorsque votre équipe peut exploiter le crawler. C'est un choix d'infrastructure, et non un équivalent gratuit d'un flux de données géré.
6. Outscraper: Pour des exports Google Maps occasionnels
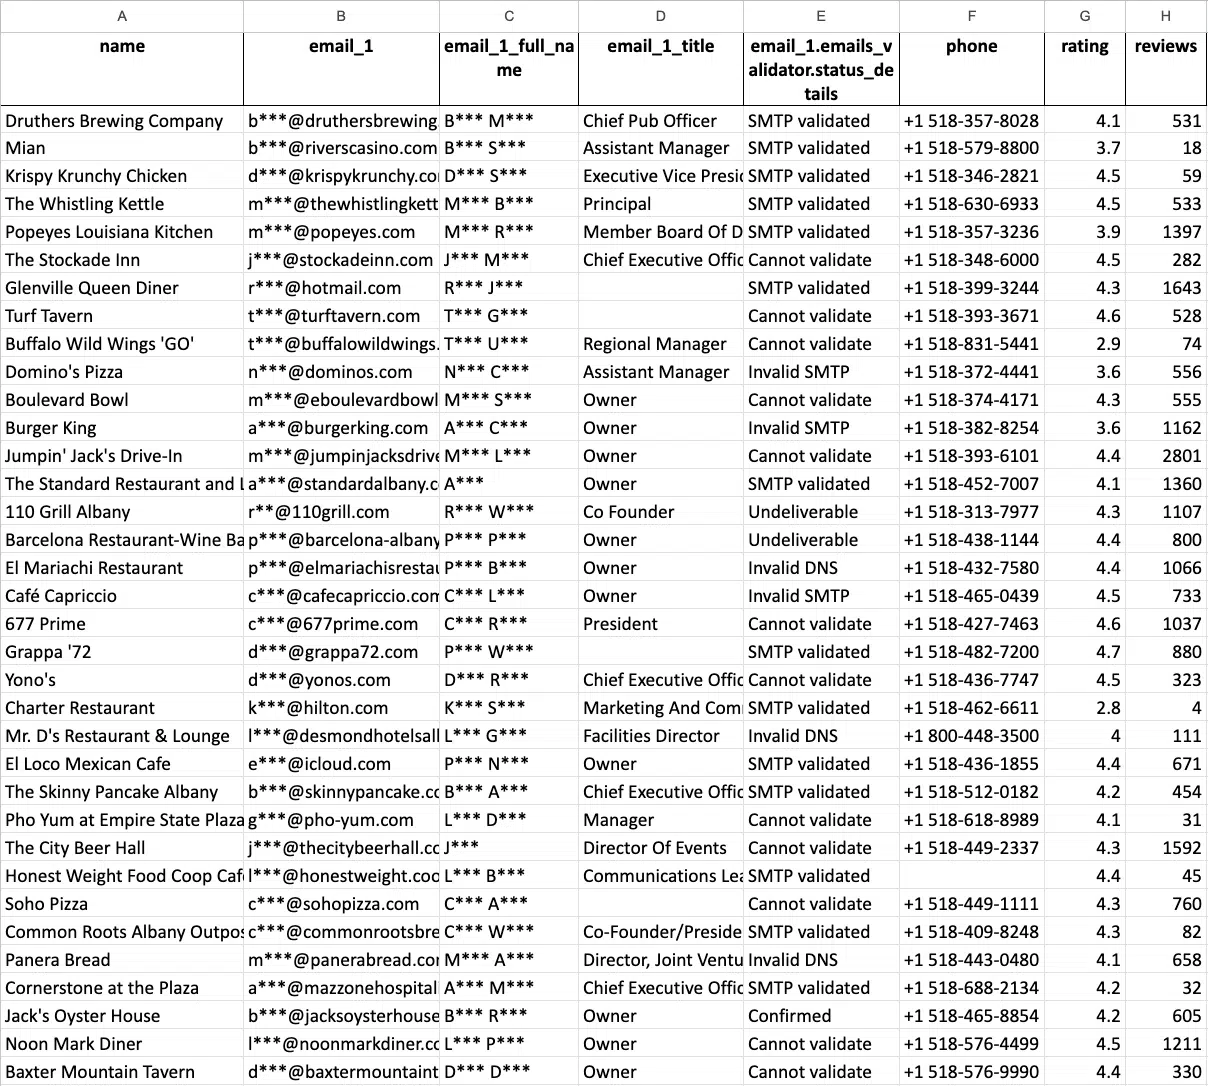
| Prix | 3 $ / 1000 enregistrements MapsUtilisation de 501 à 100000 établissements ; ensuite 1 $ / 1000 au-delà de ce palier |
|---|---|
| Idéal pour | Équipes qui veulent des enregistrements Maps sans abonnement récurrent. |
| Limites de l’offre gratuite / d’essai | Premiers 500 établissements Maps ; les paliers sont réinitialisés tous les 30 jours |
| Fonctionnalité clé | Exports d'établissements Google Maps avec enrichissement optionnel des contacts de sites web. |
| Principale limite | L'extraction Maps de base et l'enrichissement supplémentaire doivent être budgétés séparément. |
Outscraper est une option spécialisée lorsque la tâche Bright Data que vous devez remplacer est un export d'entreprises Google Maps. Il renvoie les champs de fiche et propose des services distincts pour l'enrichissement des contacts via le site web.
Pour une liste de territoires occasionnelle, l'extraction à l'usage peut être plus facile à budgéter que la maintenance d'un pipeline de collecte personnalisé. Vérifiez les mêmes emplacements, champs de fiche et doublons avant de changer de source.
Le prix de base de Maps n'inclut pas tous les enrichissements dont vous pourriez avoir besoin. Comparez l'extraction et la recherche de contacts, et conservez les identifiants de fiche pour les jointures ultérieures. Cette option ne remplace pas les API web générales, les navigateurs ou l'infrastructure proxy de Bright Data.
Un candidat ciblé pour une liste Maps. Vérifiez les champs requis et les services d'enrichissement avant de comparer le prix par enregistrement.
7. OwnerClue: Pour la recherche de prospects par les agences locales
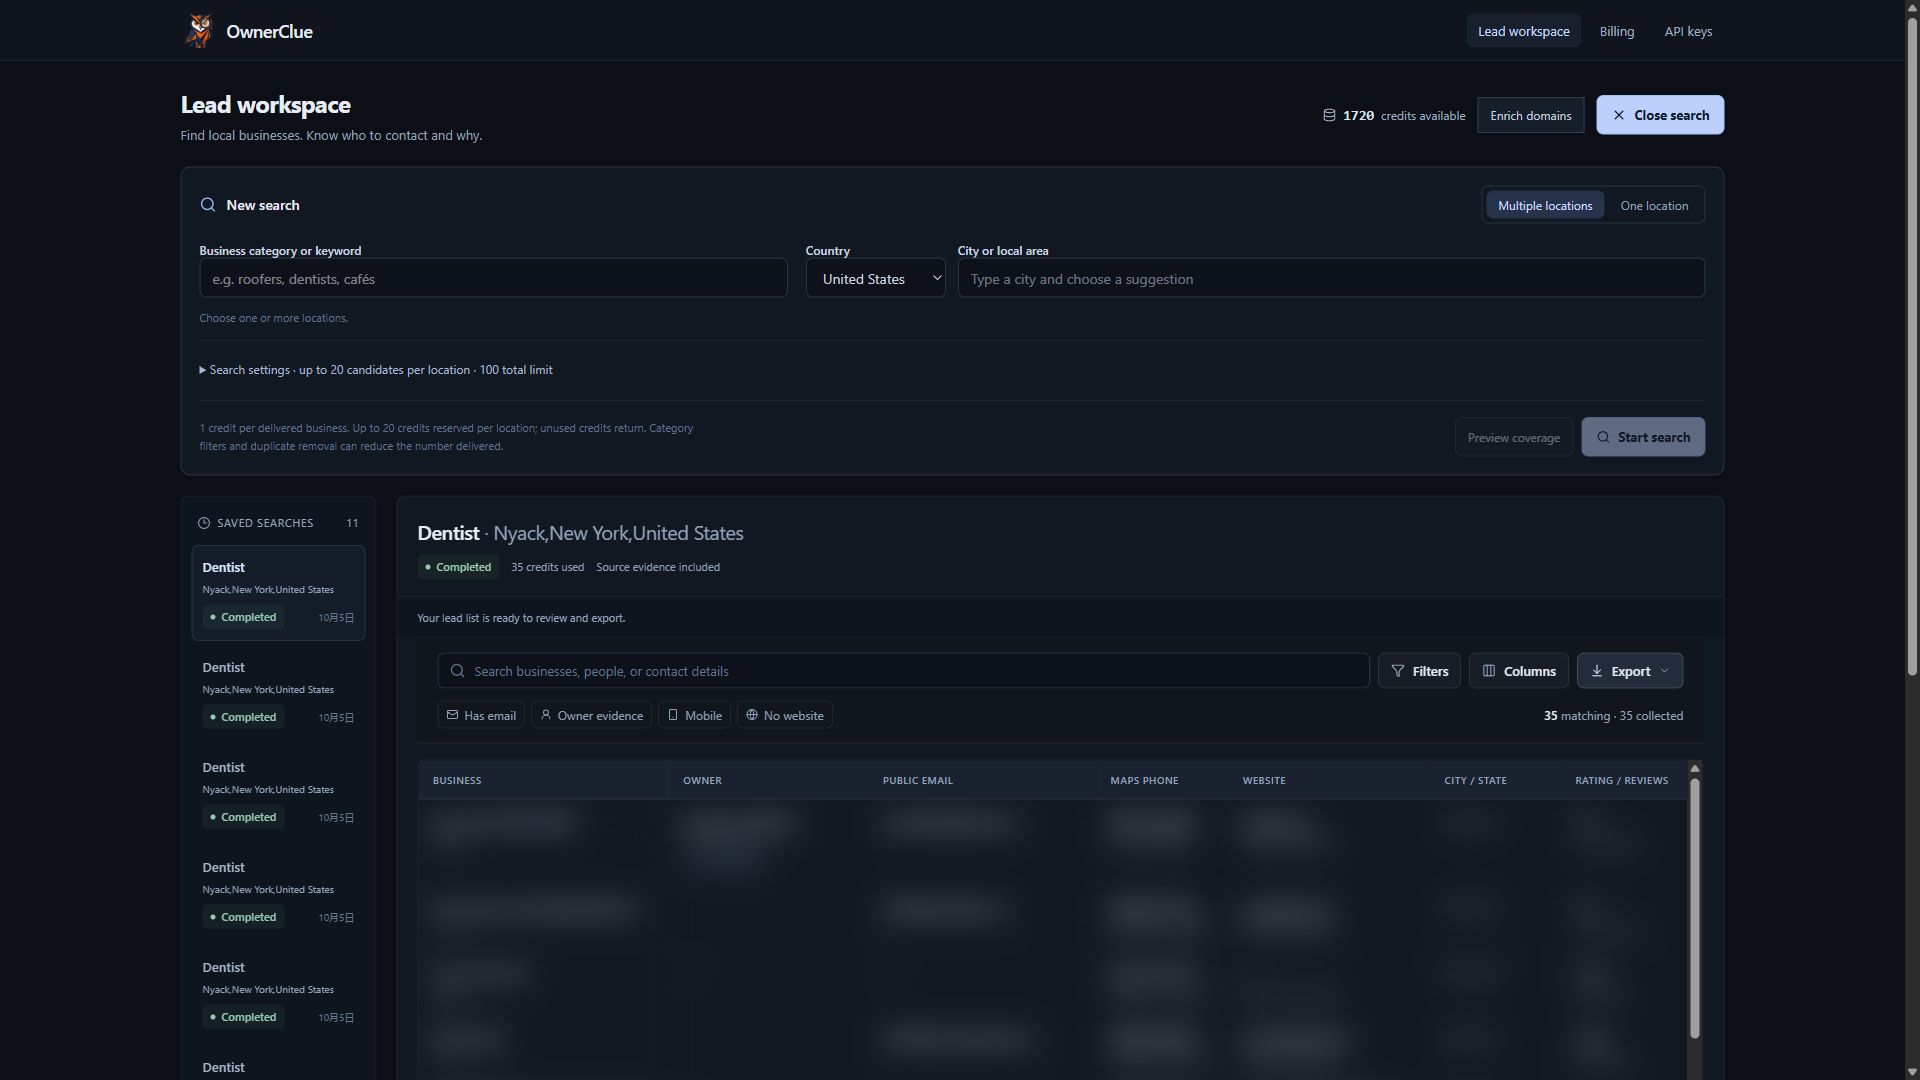
| Prix | Starter 35 $ / mois10000 crédits partagés entre les opérations prises en charge |
|---|---|
| Idéal pour | Agences de web design, de SEO local et de marketing qui recherchent des prospects locaux. |
| Limites de l’offre gratuite / d’essai | Essai unique de 20 crédits · 14 jours · aucune carte requise |
| Fonctionnalité clé | Recherche de marché local, étude de sites web, indices d’opportunité et contacts sourcés dans un seul espace de prospection. |
| Principale limite | Les contacts publics et les propriétaires peuvent être manquants. La vérification de la délivrabilité en boîte mail est distincte. |
OwnerClue convient à la mission d'agence une fois le marché local à étudier choisi. Il combine la découverte par secteur et localisation, l'observation des sites web, la revue des contacts sourcés et l'export CSV autour d'une fiche d'entreprise.
Pour une agence SEO ou de création de sites, le résultat utile est une présélection contextualisée : le site web indiqué, ce qui a pu être inspecté, les canaux de contact disponibles et les preuves de propriétaire/fondateur étayées. Cela peut réduire le besoin d'assembler la recherche dans des fichiers séparés. L'absence de site web indiqué ou de lien de réservation trouvé est un indice à creuser, pas une preuve de demande.
Bright Data peut déjà collecter des fiches d'entreprise. La raison d'être d'OwnerClue ici est le workflow de recherche d'agence, pas un accès exclusif à ces données. Il ne remplace pas les API de sources arbitraires, les proxys ou l'automatisation de navigateur. Des contacts peuvent manquer, et les transferts CSV n'offrent ni synchronisation CRM native ni vérification de la délivrabilité en boîte mail.
Envisagez-le lorsque le livrable final est une présélection de prospects pour une agence. Gardez un fournisseur d'API lorsque votre application a besoin de collecte de données web générale.
Prix et limites gratuites, côte à côte
Les montants en USD distinguent la facturation mensuelle, les équivalents annuels et les frais à l'usage. Les offres gratuites et d'évaluation apparaissent séparément dans chaque ligne.
| Outil | Accès gratuit / d'essai | Point de départ payant | Fonctionnalité clé |
|---|---|---|---|
| Bright Data | 5000 enregistrements / mois indiqués pour l'API Web Scraper | $1.50 / 1000 enregistrementsTarification à l'usage de l'API Web Scraper | API de scraping maintenues avec livraison structurée en JSON, NDJSON ou CSV. |
| Oxylabs | $5 crédits de bienvenue pour les produits · pas un quota récurrent | Starter $30 / moisAbonnement actuel Web API /Scrape. Domaines personnalisés : $1 / 1000 résultats non-JS ou $1.50 / 1000 résultats JS aux tarifs Starter | Web API /Scrape avec options de récupération et d'analyse propres à chaque cible. |
| Zyte API | $5 de crédit · évaluation de 30 jours | PAYG HTTP $0.13–$1.27 / 1000PAYG rendu par navigateur $1.01–$16.08 / 1000 ; le niveau du site et les fonctionnalités supplémentaires influent sur le coût | Récupération gérée et rendu par navigateur avec options d'extraction automatique. |
| ScrapingBee | 1000 crédits API d'essai · aucune carte requise | Freelance 49 $ / mois250000 crédits API et 50 requêtes simultanées actuellement indiqués | Récupération de pages, scénarios JavaScript et extraction CSS/XPath ou par IA. |
| Apify | 5 $ de consommation chaque mois · aucune carte requise | Starter 19 $ / mois + consommation19 $ de consommation prépayée ; les frais d’Actor et de plateforme sont déduits de ce crédit | Une place de marché d’Actors et un environnement d’exécution hébergé pour l’extraction et l’automatisation. |
| Crawlee | La bibliothèque n'a pas de frais d'abonnement logiciel | Logiciel libre et open sourceL'hébergement, les proxys, le stockage et l'ingénierie sont des coûts supplémentaires | Crawling open source en JavaScript et Python, avec une infrastructure que vous gérez. |
| Outscraper | Premiers 500 établissements Maps ; les paliers sont réinitialisés tous les 30 jours | 3 $ / 1000 enregistrements MapsUtilisation de 501 à 100000 établissements ; ensuite 1 $ / 1000 au-delà de ce palier | Exports d'établissements Google Maps avec enrichissement optionnel des contacts de sites web. |
| OwnerClue | Essai unique de 20 crédits · 14 jours · aucune carte requise | Starter 35 $ / mois10000 crédits partagés entre les opérations prises en charge | Recherche de marché local, étude de sites web, indices d’opportunité et contacts sourcés dans un seul espace de prospection. |
Les sources officielles sont liées sous chaque produit. L'essai de l'éditeur est unique. Les quotas de crédits, de pages, d'URL, de sièges et d'enregistrements mesurent des choses différentes ; confirmez la configuration choisie avant d'acheter.
Évaluez le prix de la sortie que votre application peut utiliser. La Web Scraper API de Bright Data affiche $1.50 par 1000 enregistrements livrés en paiement à l'usage. Le palier gratuit de cinq mille enregistrements appartient à ce produit ; les offres proxy, navigateur et jeux de données ont leurs propres conditions.
Les alternatives utilisent des unités différentes. Zyte facture les requêtes HTTP et navigateur selon le palier du site. ScrapingBee vend des crédits que les réglages peuvent multiplier. Oxylabs facture par cible et configuration, avec des tarifs d'analyse IA distincts. Un Actor Apify peut facturer par événement ou par usage de la plateforme. Ce ne sont pas des lignes interchangeables de “records.”
Utilisez un échantillon représentatif contenant les mises en page et les exigences de rendu qui rendent la vraie tâche difficile. Ne comptez que les sorties comportant les champs requis, puis ajoutez l'analyse, l'enrichissement, le stockage et le travail d'exploitation que le remplacement vous laisse. Conservez les mêmes critères d'acceptation des deux côtés.
Coût par enregistrement utilisable = coût total de collecte et de traitement ÷ enregistrements conformes au cahier des charges
How to replace your Bright Data workflow
Le pilote le plus sûr remplace d'abord une source ou une tâche de recherche. Laissez les autres services Bright Data en place jusqu'à ce que leur remplacement soit démontré.
| Sortie actuelle | Parcours de remplacement | Vérification du pilote | Travail qui reste à votre charge |
|---|---|---|---|
| Enregistrements de source structurés | Oxylabs, l'extraction Zyte ou un Actor Apify | Mêmes URL, champs obligatoires, identifiants, rendu et fraîcheur | Mappage de schéma, transfert de livraison, vérifications des champs manquants |
| Contenu de page pour votre parseur | Zyte API, ScrapingBee ou Crawlee + récupération | Sortie HTML/rendue et coût d'une récupération réussie | Découverte d'URL, analyse, planifications et surveillance |
| Liste restreinte de prospects locaux | Outscraper ou OwnerClue | Même secteur/territoire et contexte de contact requis | Vérification, exclusions, import CSV et tout workflow d'envoi |
1. Remplacer un scraper maintenu
Figez un échantillon d'URL sources et de champs de sortie requis. Exécutez le candidat avec des paramètres de rendu et d'extraction équivalents. Comparez les identifiants, les variantes, les horodatages, les valeurs manquantes et le nombre d'enregistrements livrés. Adaptez le transfert API ou webhook, puis exécutez un cycle planifié avant de lui confier le volume restant.
2. Changer la récupération sans changer tout le pipeline
Conservez votre file de découverte et votre parseur en aval. Remplacez la couche de requête pour un petit ensemble d'URL et inspectez le contenu renvoyé avant l'analyse. Confirmez quelles réponses sont facturées et quelles options ajoutent des coûts. Recréez le comportement de nouvelle tentative et de surveillance dans votre application si nécessaire. Un point de terminaison de récupération n'est ni un planificateur complet ni un système de qualité des données.
3. Simplifier une tâche de recherche sur les entreprises locales
Définissez le secteur, le territoire et les champs de contact dont vous avez réellement besoin. Comparez un export Maps via Outscraper avec une liste restreinte de recherche d'agence dans OwnerClue. Inspectez les associations de sites web et les sources de contacts, conservez les identifiants d'origine et exportez les entreprises acceptées. Gardez Bright Data pour la collecte de produits, de réseaux sociaux ou de sources personnalisées sans rapport.
- Définir les champs obligatoires
- Exécuter des URL sources appariées
- Mapper et inspecter la sortie
- Déplacer une source planifiée
Quelle alternative choisir ?
Pour un développeur qui achète de l'extraction gérée
Comparez Oxylabs avec le point de terminaison source exact et les besoins d'analyse. Comparez Zyte lorsque la récupération ciblée par niveau correspond à votre pipeline existant. Choisissez ScrapingBee lorsque des paramètres de récupération et d'extraction configurables conviennent à l'application. Sélectionnez à partir des résultats d'échantillons réels et du coût plutôt que du tarif publié le plus bas.
Pour une équipe qui souhaite plus de contrôle sur le code
Utilisez Apify pour un Actor vérifié ou un programme hébergé personnalisé. Choisissez Crawlee lorsque l'exploitation du code et de l'infrastructure est une décision délibérée de l'équipe. Vous pouvez combiner une bibliothèque de crawler avec une récupération gérée ; ces outils ne sont pas mutuellement exclusifs.
Pour une agence qui prépare des listes de ventes locales
Choisissez Outscraper pour des exports d'annonces occasionnels, ou envisagez OwnerClue pour une liste restreinte incluant des observations de sites web et une vérification des contacts sourcés. Ces outils remplacent une tâche de recherche d'entreprises. Ils sont de mauvais choix lorsque le besoin est l'extraction de sources arbitraires, l'exécution de navigateur à distance ou un service de proxy général.
When to keep Bright Data
Conservez Bright Data si son scraper maintenu renvoie déjà les champs dont votre application a besoin et si l'intégration de livraison est stable. Sa tarification à l'enregistrement peut aussi être plus simple pour cette tâche que l'exploitation de votre propre parseur autour d'un point de terminaison de récupération moins cher.
Si vous utilisez plusieurs produits Bright Data, comparez-les séparément. Une migration de scraper réussie ne prouve pas que vous devez déplacer les proxys, les navigateurs ou les jeux de données achetés. Pour une petite tâche sur des sources prises en charge, vérifiez le niveau gratuit mensuel de l'API Web Scraper avant de payer pour un remplacement.
Questions fréquentes
Quelle est l'alternative la plus proche de Bright Data ?
Pour l'extraction gérée, commencez par Oxylabs ou Zyte API et comparez la source exacte et la sortie. Pour un point de terminaison configurable, envisagez ScrapingBee. Ce guide ne prétend pas qu'un seul outil remplace l'ensemble de l'offre de proxys, navigateurs, scrapers et jeux de données de Bright Data.
Existe-t-il une alternative gratuite à Bright Data ?
Crawlee n'a pas de frais de logiciel, mais son exploitation n'est pas gratuite. Apify inclut 5 $ de crédit d'utilisation par mois et Outscraper dispose d'un niveau gratuit Maps limité. Bright Data lui-même indique 5000 enregistrements de l'API Web Scraper par mois gratuits. Les crédits d'essai des fournisseurs d'API ne doivent pas être comptés comme un accès récurrent.
Pourquoi une requête moins chère peut-elle produire un enregistrement plus coûteux ?
Le remplacement peut renvoyer du HTML au lieu de champs analysés, nécessiter plusieurs requêtes pour un seul enregistrement ou consommer des crédits supplémentaires pour le rendu et l'extraction. Les champs manquants peuvent aussi créer du travail de nettoyage. Comparez le coût total de la tâche avec le nombre de sorties acceptées selon les mêmes critères.
Puis-je conserver Bright Data et ajouter un outil de recherche distinct ?
Oui. Conservez l'étape de collecte qui fonctionne, puis testez une étape distincte d'enrichissement ou de vérification sur les domaines exportés. OwnerClue accepte jusqu'à 100 lignes de domaines par lot. Joignez les résultats vérifiés par domaine et conservez les sources. Il s'agit d'un transfert de fichiers, et non d'un remplacement natif du pipeline API existant.
OwnerClue remplace-t-il un proxy ou une API de navigateur ?
Non. Il sert à la découverte d'entreprises locales et à la recherche de sites web et de contacts pour les agences. Il ne propose pas de réseau proxy général, de scraper de sources arbitraires ni d'environnement de navigateur distant. Utilisez les candidats axés sur les API pour ces tâches d'infrastructure.
Testez le workflow avant de changer
Remplacez le produit et la sortie que vous utilisez réellement. Commencez par une source, alignez les champs et les paramètres de rendu, puis comparez le coût par enregistrement exploitable et le travail opérationnel qui reste à votre équipe.
Si la recherche de prospects pour agences locales est votre priorité, essayez une petite liste dans OwnerClue. L'essai unique inclut 20 crédits, valables 14 jours, sans carte requise.