7 Alternativas a Bright Data para web scraping y datos de empresas (2026)
Bright Data vende varios productos: proxies, API de acceso, API de scraping, navegadores y conjuntos de datos. Una buena alternativa a uno de ellos no lo es automáticamente para el resto. Esta guía se centra en la recopilación de datos de sitios web y de empresas, con la Web Scraper API como referencia de precios.
Respuesta rápida
Para una API de scraping gestionada, compara Oxylabs y Zyte API con la fuente exacta y el modo de renderizado que necesitas. ScrapingBee encaja como un endpoint configurable dentro de un pipeline que ya controlas.
Para scrapers listos para usar o trabajos alojados personalizados, consulta Apify. Para código de rastreador que operas tú mismo, considera Crawlee.
Para listas de negocios locales, Outscraper encaja en exportaciones ocasionales de Maps; OwnerClue encaja en la investigación de agencias con observaciones de sitios web y contactos con fuentes. No reemplazan una red de proxies general ni una API de navegador.
Conserva Bright Data cuando su scraper mantenido, su formato de entrega o su infraestructura más amplia ya cumplan el requisito. Su Web Scraper API también incluye un nivel gratuito mensual de 5000 registros.
¿Qué Bright Data alternativa se ajusta a tu tarea?
3 preguntas rápidas · opcionalCómo comparamos estas alternativas
Revisamos las páginas oficiales de los productos, la documentación y los precios según el trabajo que cada herramienta puede asumir, el coste de inicio, los límites gratuitos o de prueba y lo que necesitarías reconstruir. Los precios se verificaron el October 12, 2026.
OwnerClue publica esta guía y se incluye a continuación. Se trata de una comparación basada en documentación, no en una prueba de rendimiento. Las capturas de sitios web identifican productos y condiciones de los planes; las demostraciones oficiales y el espacio de trabajo censurado se etiquetan en sus pies de foto.
| Qué comparamos | Por qué importa |
|---|---|
| Producto y resultado | Los proxies, el contenido de páginas, los registros analizados y los conjuntos de datos previamente recopilados son entregables diferentes. |
| Objetivo y campos exactos | Un scraper de fuentes mantenido y una solicitud a un dominio personalizado pueden tener esquemas y tarifas diferentes. |
| Renderizado y análisis | JavaScript, la interacción, las opciones de extracción y los niveles de destino cambian el costo del resultado utilizable. |
| Responsabilidad del pipeline | Alguien sigue teniendo que encargarse del descubrimiento, la programación, el mapeo de campos y la supervisión de datos faltantes. |
En esta página
Why look for alternatives to Bright Data?
Empieza por nombrar el producto de Bright Data que quieres reemplazar. Un proxy transporta tráfico; una API de recuperación devuelve el contenido de la página; un scraper mantenido devuelve campos estructurados; un conjunto de datos proporciona una colección existente. Esos resultados conllevan costos y responsabilidades diferentes.
Un scraper de fuentes compatibles es la comparación más cercana cuando tu aplicación espera un esquema estable de producto, perfil o anuncio. Verifica los campos específicos, las variantes de fuente, la actualidad y el método de entrega. Una respuesta HTML más barata no es equivalente si tu equipo tiene que mantener el análisis.
Un servicio de recuperación es relevante cuando ya controlas la cola de URL y el código de extracción. Compara la compatibilidad con JavaScript, la configuración de solicitudes, los formatos de respuesta y cómo la extracción opcional cambia la factura.
Una herramienta de investigación de empresas es una opción más limitada cuando el objetivo final es una lista revisada de prospectos locales. Puede eliminar parte del trabajo de ensamblaje para esa tarea, sin tocar la infraestructura de recopilación más amplia. No migres un pipeline de monitoreo de precios ni un flujo de trabajo de navegador personalizado a una herramienta creada para prospectos locales.
The 7 Bright Data alternatives
Estas herramientas asumen distintas partes del trabajo. Cada una usa el mismo formato de datos rápidos, seguido de un caso de uso práctico y una limitación que podría cambiar tu elección.
1. Oxylabs: Para una API de scraping gestionada
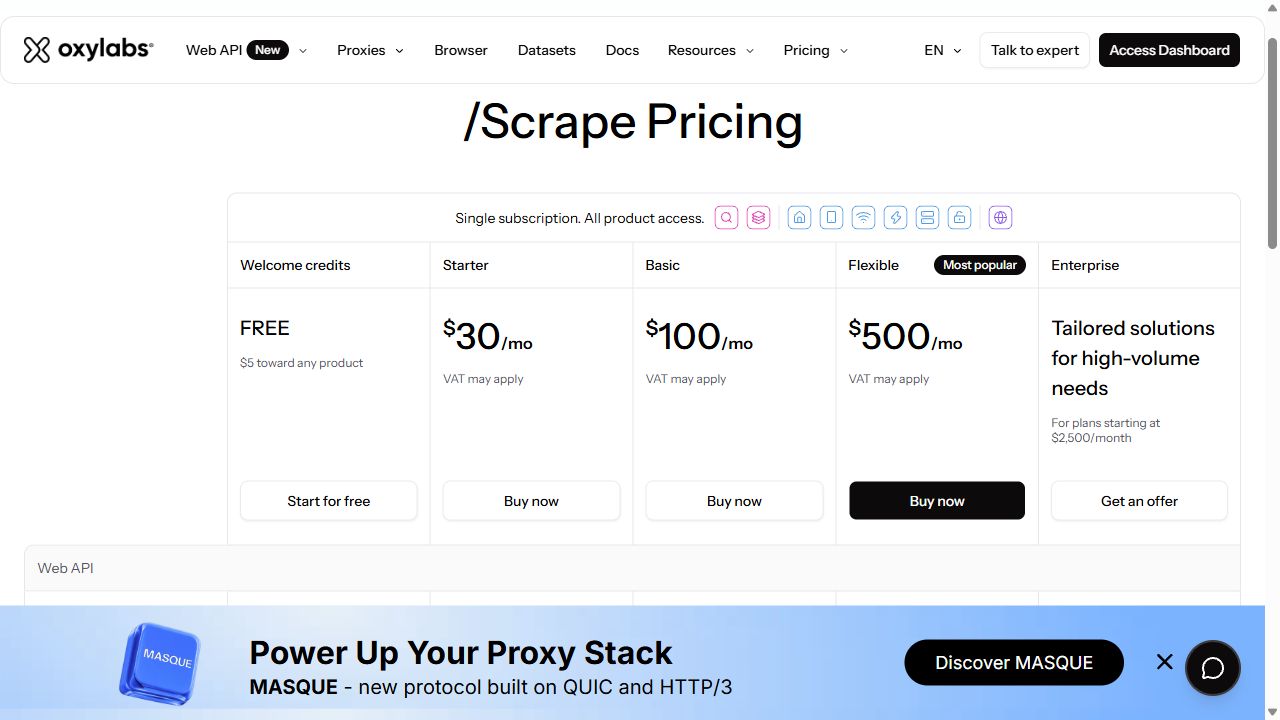
| Precio | Starter $30 / mesSuscripción actual a Web API /Scrape. Dominios personalizados: $1 / 1000 resultados sin JS o $1.50 / 1000 resultados con JS a tarifas de Starter |
|---|---|
| Ideal para | Desarrolladores que necesitan recuperación gestionada y endpoints de scraping específicos por fuente. |
| Límites de uso gratuito / de prueba | $5 en créditos de bienvenida para productos · no es una asignación recurrente |
| Función clave | Web API /Scrape con opciones de recuperación y análisis específicas por objetivo. |
| Limitación principal | La fuente, el renderizado y el análisis con IA modifican la tarifa; la tarifa anunciada más baja no es un precio universal. |
Oxylabs es un candidato directo relevante para la parte de scraping gestionado de Bright Data. Su antigua URL de precios de Web Scraper API ahora redirige a Web API /Scrape, con una suscripción compartida y tarifas específicas por objetivo.
Para un dominio personalizado, la tabla de Starter enumera tarifas separadas para JavaScript y sin JavaScript. Amazon, Google y otros objetivos tienen sus propias filas, y el análisis con IA se factura por separado.
Compara el endpoint y el esquema devuelto que tu pipeline realmente necesita. No uses la tarifa más baja de Amazon para estimar un sitio personalizado renderizado en navegador. Una prueba debe incluir tus páginas difíciles además de las fáciles.
Un candidato cercano para la recopilación mediante API. Calcula el precio de la fuente exacta, el modo de renderizado y la configuración de análisis.
2. Zyte API: Para la recuperación de sitios web basada en uso
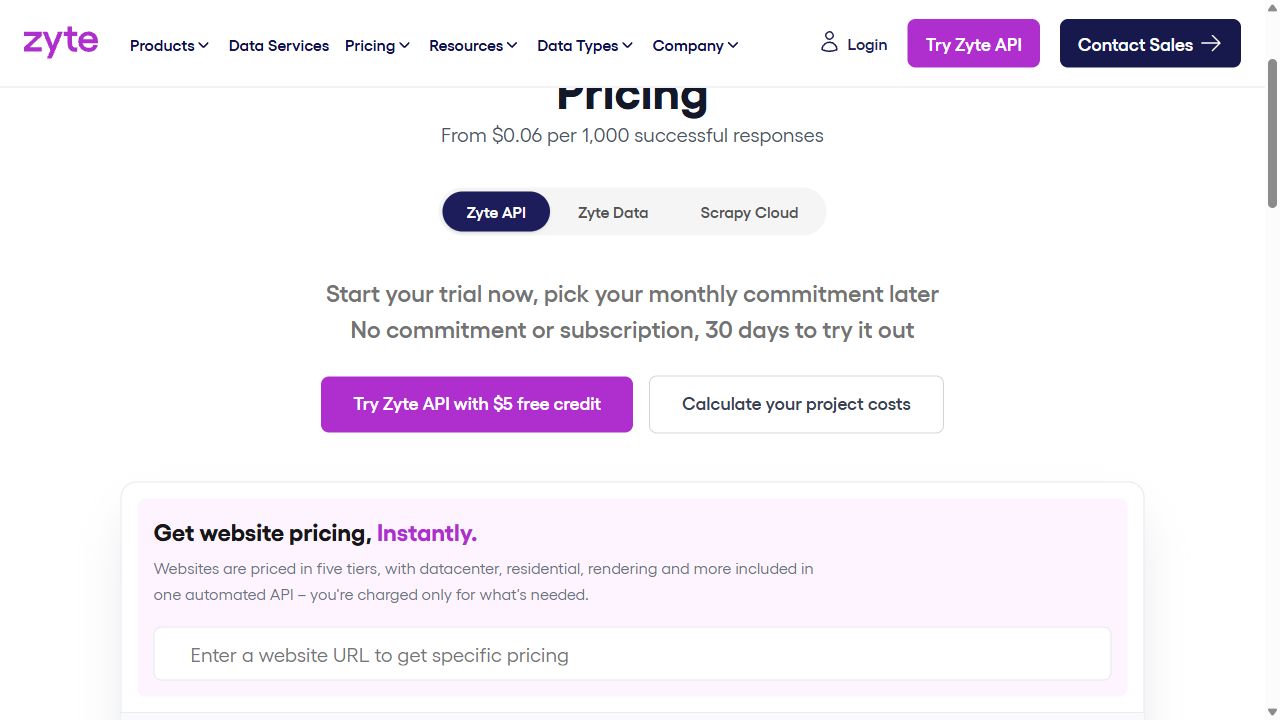
| Precio | PAYG HTTP $0.13–$1.27 / 1000PAYG con renderizado en navegador $1.01–$16.08 / 1000; el nivel del sitio y las funciones adicionales afectan al coste |
|---|---|
| Ideal para | Desarrolladores que quieren acceso gestionado sin renunciar a su pipeline de rastreo. |
| Límites de uso gratuito / de prueba | $5 de crédito · evaluación de 30 días |
| Función clave | Recuperación gestionada y renderizado en navegador con opciones de extracción automática. |
| Limitación principal | Los costes de HTTP, navegador y extracción difieren; la tarifa mínima destacada presupone un compromiso. |
Zyte API es útil cuando quieres mantener la cola de URL y el pipeline posterior pero trasladar la recuperación y el renderizado a un servicio gestionado. Sus solicitudes HTTP y de navegador tienen precios diferentes, y el sitio web objetivo determina el nivel.
Eso importa en un rastreo mixto: un artículo estático fácil y una página de producto renderizada difícil no deberían recibir la misma estimación de coste. La extracción automática y otras opciones pueden añadir cargos.
La tarifa mínima destacada de la página de precios pertenece a un plan con compromiso. La tabla aquí usa rangos de pago por uso para que la comparación no presuponga un compromiso mensual que no has elegido.
Considéralo para un pipeline que tus desarrolladores ya controlan. Estima los costes con URL representativas y la misma configuración de extracción.
3. ScrapingBee: Para un endpoint de scraping configurable
| Precio | Freelance $49 / mes250000 créditos de API y 50 solicitudes concurrentes indicados actualmente |
|---|---|
| Ideal para | Desarrolladores que obtienen páginas y extraen campos seleccionados en una aplicación existente. |
| Límites de uso gratuito / de prueba | 1000 créditos de API de prueba · no se requiere tarjeta |
| Función clave | Obtención de páginas, escenarios de JavaScript y extracción con CSS/XPath o IA. |
| Limitación principal | Una solicitud puede consumir varios créditos según las opciones de renderizado, proxy y extracción. |
ScrapingBee es adecuado para un desarrollador que quiere solicitar una URL y elegir cómo se obtiene o extrae. Sus opciones documentadas incluyen interacciones con JavaScript, extracción basada en selectores y extracción con IA.
Para un rastreador de precios, comienza con la configuración más simple que devuelva los campos requeridos. Añade renderizado o interacción solo cuando la fuente lo requiera y comprueba los créditos resultantes por página exitosa.
La tarjeta Freelance actual indica 250000 créditos. Eso es un presupuesto de créditos, no una promesa de 250000 páginas renderizadas ni de registros de producto completos. Tu aplicación aún necesita programar solicitudes, mapear salidas y monitorear campos faltantes.
Un endpoint práctico para un pipeline propio. Compara créditos por salida utilizable, no solo los créditos anunciados.
4. Apify: Para scrapers listos para usar y tareas personalizadas en la nube
| Precio | Starter $19 / mes + usoUso prepago de $19; los cargos de Actor y de la plataforma se descuentan de esa cuota |
|---|---|
| Ideal para | Equipos que combinan scrapers compatibles con API, programaciones o código personalizado. |
| Límites de uso gratuito / de prueba | $5 de uso cada mes · no se requiere tarjeta |
| Función clave | Un mercado de Actors y un entorno de ejecución alojado para extracción y automatización. |
| Limitación principal | Las entradas, salidas, precios y mantenimiento de los Actors varían según el desarrollador. |
Apify es un candidato útil cuando un Actor ya hecho cubre tu fuente o cuando necesitas lógica personalizada en torno a la recolección. Su entorno de ejecución alojado, programaciones, conjuntos de datos y API se adaptan a un trabajo de varios pasos con más de una etapa de extracción.
Para un minorista que rastrea un conjunto definido de URL de productos, revisa el precio, la disponibilidad, los identificadores y las marcas de tiempo del Actor seleccionado. Dos Actores para el mismo sitio pueden diferir en campos, mantenimiento y facturación.
Esta es una decisión de plataforma y Actor, no un reemplazo directo de proxy. Incluye los cargos por evento o uso del Actor y cualquier consumo adicional de la plataforma. Ejecuta una muestra pequeña antes de estimar el costo mensual del pipeline.
Elige esta opción cuando un Actor verificado o un programa alojado personalizado sea el factor decisivo. Compara su salida completa y facturación con el scraper actual de Bright Data.
5. Crawlee: Para un rastreador que tu equipo administra
| Precio | Software gratuito de código abiertoEl alojamiento, los proxies, el almacenamiento y la ingeniería son costos adicionales |
|---|---|
| Ideal para | Desarrolladores que construirán y operarán su propio código de extracción. |
| Límites de uso gratuito / de prueba | La biblioteca no tiene tarifa de suscripción de software |
| Función clave | Rastreo de código abierto en JavaScript y Python, con infraestructura que tú administras. |
| Limitación principal | Tu equipo se encarga de la ejecución, el monitoreo, la infraestructura y el mantenimiento. |
Crawlee es la opción cuando el control sobre el código de extracción importa más que comprar un servicio de datos mantenido. Es una biblioteca de rastreo de código abierto de Apify, con puntos de entrada en JavaScript y Python.
Para un equipo que recopila un conjunto cambiante de fuentes de investigación internas, tener la cola de solicitudes y el código de análisis puede ser útil. Pero ese equipo también se encarga de la ejecución, el almacenamiento, las programaciones, el monitoreo y el mantenimiento cuando un sitio cambia.
Crawlee no incluye una red de proxies ni un reemplazo listo para los esquemas de origen de Bright Data. Aun así, puedes usar un servicio gestionado de obtención o proxy debajo de él. Presupuesta la infraestructura y la ingeniería antes de considerar la ausencia de una tarifa de software como un costo total menor.
Considéralo cuando tu equipo pueda operar el rastreador. Es una elección de infraestructura, no un equivalente gratuito de un feed de datos gestionado.
6. Outscraper: Para exportaciones ocasionales de Google Maps
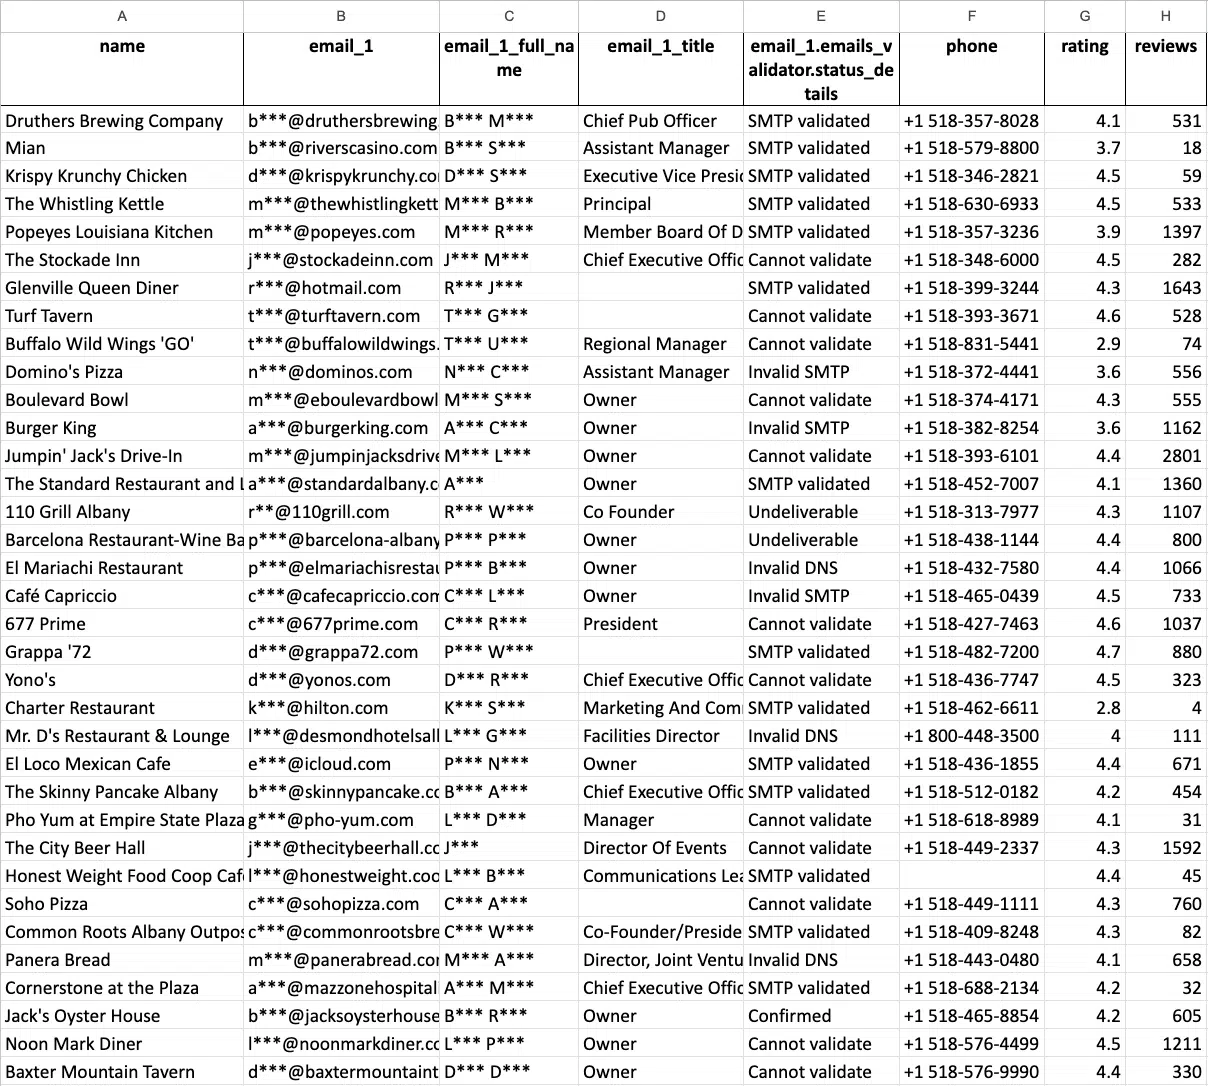
| Precio | $3 / 1000 registros de MapsUso desde 501 hasta 100000 negocios; después $1 / 1000 por encima de ese nivel |
|---|---|
| Ideal para | Equipos que quieren registros de Maps sin una suscripción recurrente. |
| Límites de uso gratuito / de prueba | Primeros 500 negocios de Maps; los niveles se restablecen cada 30 días |
| Función clave | Exportaciones de negocios de Google Maps con enriquecimiento opcional de contactos de sitios web. |
| Limitación principal | La extracción base de Maps y el enriquecimiento adicional requieren presupuestos separados. |
Outscraper es una opción especializada cuando el trabajo de Bright Data que necesitas sustituir es una exportación de negocios de Google Maps. Devuelve campos de listado y ofrece servicios independientes para el enriquecimiento de contactos de sitios web.
Para una lista de territorios ocasional, la extracción basada en uso puede ser más fácil de presupuestar que mantener una canalización de recopilación personalizada. Verifica las mismas ubicaciones, los campos de listado y los duplicados antes de cambiar la fuente.
El precio base de Maps no incluye todos los enriquecimientos que podrías necesitar. Compara la extracción más la investigación de contactos y conserva los identificadores de listado para futuras uniones. Esta opción no sustituye las API generales de sitios web, los navegadores ni la infraestructura de proxy de Bright Data.
Un candidato específico para una lista de Maps. Comprueba los campos requeridos y los servicios de enriquecimiento antes de comparar el precio por registro.
7. OwnerClue: Para investigación de prospectos de agencias locales
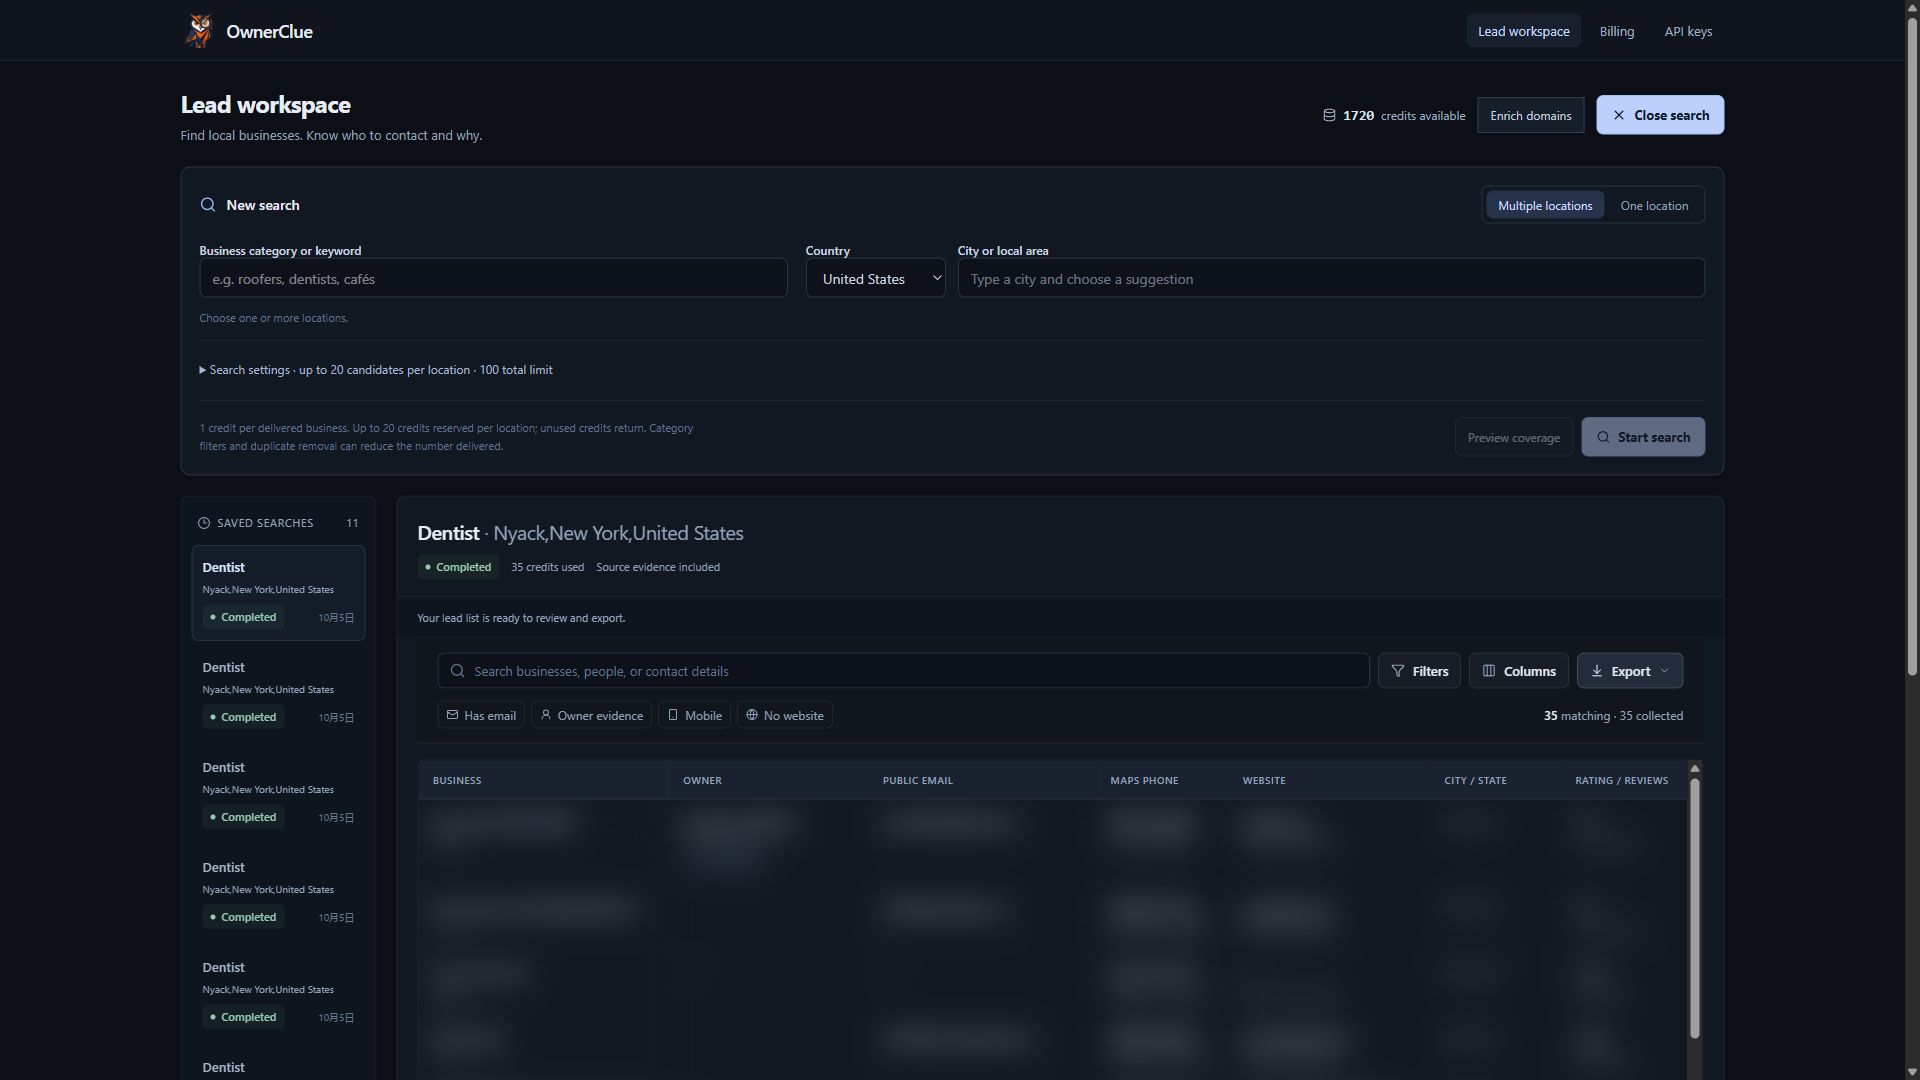
| Precio | Starter $35 / mes10000 créditos compartidos entre las operaciones compatibles |
|---|---|
| Ideal para | Agencias de diseño web, SEO local y marketing que investigan prospectos locales. |
| Límites de uso gratuito / de prueba | Prueba única de 20 créditos · 14 días · sin tarjeta |
| Función clave | Búsqueda de mercado local, investigación de sitios web, indicios de oportunidad y contactos con fuente en un único espacio de prospección. |
| Limitación principal | Es posible que falten contactos públicos y propietarios. La verificación de entrega al buzón es independiente. |
OwnerClue encaja en el trabajo de la agencia después de decidir qué mercado local investigar. Combina el descubrimiento por sector y ubicación, las observaciones de sitios web, la revisión de contactos con fuentes y la exportación a CSV en torno a un registro de empresa.
Para una agencia de SEO o diseño web, el resultado útil es una preselección con contexto: el sitio web listado, lo que se pudo inspeccionar, las vías de contacto disponibles y la evidencia documentada de propietario/fundador. Esto puede reducir la necesidad de reunir la investigación en archivos separados. Que no haya un sitio web listado o que no se encuentre un enlace de reserva es una pista para investigar, no una prueba de demanda.
Bright Data ya puede recopilar registros de empresas. La razón de ser de OwnerClue aquí es el flujo de trabajo de investigación de la agencia, no el acceso exclusivo a esos datos. No sustituye las API de fuentes arbitrarias, los proxies ni la automatización de navegadores. Pueden faltar contactos, y las transferencias por CSV no ofrecen sincronización nativa con el CRM ni verificación de entrega en el buzón.
Considéralo cuando el producto final sea una preselección de prospectos para la agencia. Mantén un proveedor de API cuando tu aplicación necesite recopilación general de datos web.
Precios y límites gratuitos, en paralelo
Las cifras en USD distinguen la facturación mensual, los equivalentes anuales y los cargos por uso. Los planes gratuitos y las ofertas de evaluación aparecen por separado en cada fila.
| Herramienta | Acceso gratuito / de prueba | Punto de partida de pago | Función clave |
|---|---|---|---|
| Bright Data | 5000 registros / mes indicados para la Web Scraper API | $1.50 / 1000 registrosPrecios de pago por uso de la Web Scraper API | APIs de scraping mantenidas con entrega estructurada en JSON, NDJSON o CSV. |
| Oxylabs | $5 en créditos de bienvenida para productos · no es una asignación recurrente | Starter $30 / mesSuscripción actual a Web API /Scrape. Dominios personalizados: $1 / 1000 resultados sin JS o $1.50 / 1000 resultados con JS a tarifas de Starter | Web API /Scrape con opciones de recuperación y análisis específicas por objetivo. |
| Zyte API | $5 de crédito · evaluación de 30 días | PAYG HTTP $0.13–$1.27 / 1000PAYG con renderizado en navegador $1.01–$16.08 / 1000; el nivel del sitio y las funciones adicionales afectan al coste | Recuperación gestionada y renderizado en navegador con opciones de extracción automática. |
| ScrapingBee | 1000 créditos de API de prueba · no se requiere tarjeta | Freelance $49 / mes250000 créditos de API y 50 solicitudes concurrentes indicados actualmente | Obtención de páginas, escenarios de JavaScript y extracción con CSS/XPath o IA. |
| Apify | $5 de uso cada mes · no se requiere tarjeta | Starter $19 / mes + usoUso prepago de $19; los cargos de Actor y de la plataforma se descuentan de esa cuota | Un mercado de Actors y un entorno de ejecución alojado para extracción y automatización. |
| Crawlee | La biblioteca no tiene tarifa de suscripción de software | Software gratuito de código abiertoEl alojamiento, los proxies, el almacenamiento y la ingeniería son costos adicionales | Rastreo de código abierto en JavaScript y Python, con infraestructura que tú administras. |
| Outscraper | Primeros 500 negocios de Maps; los niveles se restablecen cada 30 días | $3 / 1000 registros de MapsUso desde 501 hasta 100000 negocios; después $1 / 1000 por encima de ese nivel | Exportaciones de negocios de Google Maps con enriquecimiento opcional de contactos de sitios web. |
| OwnerClue | Prueba única de 20 créditos · 14 días · sin tarjeta | Starter $35 / mes10000 créditos compartidos entre las operaciones compatibles | Búsqueda de mercado local, investigación de sitios web, indicios de oportunidad y contactos con fuente en un único espacio de prospección. |
Las fuentes oficiales están enlazadas bajo cada producto. La prueba del editor es única. Los límites de créditos, páginas, URL, licencias y registros miden cosas distintas; confirma la configuración seleccionada antes de comprar.
Calcula el precio del resultado que tu aplicación puede usar. La Web Scraper API de Bright Data indica $1.50 por 1000 registros entregados en pago por uso. El nivel gratuito de cinco mil registros pertenece a ese producto; las ofertas de proxy, navegador y conjuntos de datos tienen sus propias condiciones.
Las alternativas usan unidades diferentes. Zyte fija el precio de las solicitudes HTTP y de navegador según el nivel del sitio. ScrapingBee vende créditos que la configuración puede multiplicar. Oxylabs fija el precio por objetivo y configuración, con tarifas de análisis de IA aparte. Un Actor de Apify puede cobrar por evento o por uso de la plataforma. No son filas intercambiables de “records.”
Usa una muestra representativa que contenga los diseños de página y los requisitos de renderizado que hacen difícil el trabajo real. Cuenta solo los resultados con los campos requeridos y luego añade el análisis, el enriquecimiento, el almacenamiento y el trabajo operativo que el sustituto deja a tu cargo. Mantén los mismos criterios de aceptación en ambos lados.
Costo por registro utilizable = costo total de recopilación y procesamiento ÷ registros que cumplen el encargo
How to replace your Bright Data workflow
El piloto más seguro sustituye primero una fuente o un trabajo de investigación. Deja los demás servicios de Bright Data en su lugar hasta que se demuestre su sustitución.
| Resultado actual | Ruta de sustitución | Comprobación del piloto | Trabajo que sigues asumiendo |
|---|---|---|---|
| Registros de fuente estructurados | Oxylabs, extracción de Zyte o un Actor de Apify | Las mismas URL, campos obligatorios, identificadores, renderizado y frescura | Mapeo de esquema, entrega de datos, comprobaciones de campos faltantes |
| Contenido de la página para tu parser | Zyte API, ScrapingBee o Crawlee + recuperación | Salida HTML/renderizada y coste de una extracción correcta | Descubrimiento de URL, análisis, programaciones y monitorización |
| Lista corta de prospectos locales | Outscraper u OwnerClue | El mismo sector/territorio y el contexto de contacto requerido | Revisión, exclusiones, importación de CSV y cualquier flujo de envío |
1. Sustituir un scraper mantenido
Congela una muestra de URL de origen y campos de salida obligatorios. Ejecuta el candidato con ajustes de renderizado y extracción equivalentes. Compara identificadores, variantes, marcas de tiempo, valores faltantes y recuentos de registros entregados. Adapta la entrega por API o webhook y, después, ejecuta un ciclo programado antes de derivarle el volumen restante.
2. Cambiar la recuperación sin cambiar todo el pipeline
Conserva tu cola de descubrimiento y tu parser posterior. Sustituye la capa de solicitudes para un conjunto pequeño de URL e inspecciona el contenido devuelto antes de analizarlo. Confirma qué respuestas se cobran y qué opciones añaden costes. Recrea el comportamiento de reintentos y monitorización en tu aplicación cuando sea necesario. Un endpoint de recuperación no es un programador ni un sistema de calidad de datos completos.
3. Simplificar una tarea de investigación de negocios locales
Define el sector, el territorio y los campos de contacto que realmente necesitas. Compara una exportación de Maps mediante Outscraper con una lista corta de investigación de agencia en OwnerClue. Inspecciona las asociaciones de sitios web y las fuentes de contacto, conserva los identificadores originales y exporta los negocios aceptados. Mantén Bright Data para la recopilación no relacionada de productos, redes sociales o fuentes personalizadas.
- Definir los campos obligatorios
- Ejecutar URL de origen emparejadas
- Mapear e inspeccionar la salida
- Mover una fuente programada
¿Qué alternativa deberías elegir?
Para un desarrollador que compra extracción gestionada
Compara Oxylabs con el endpoint de origen exacto y las necesidades de análisis. Compara Zyte cuando la recuperación por niveles de destino encaje en tu pipeline existente. Elige ScrapingBee cuando los parámetros configurables de obtención y extracción se ajusten a la aplicación. Selecciona a partir de los resultados de muestra reales y del coste, no de la tarifa publicada más baja.
Para un equipo que quiere más control sobre el código
Usa Apify para un Actor verificado o un programa personalizado alojado. Elige Crawlee cuando operar el código y la infraestructura sea una decisión deliberada del equipo. Puedes combinar una biblioteca de rastreo con recuperación gestionada; estas herramientas no son mutuamente excluyentes.
Para una agencia que prepara listas de ventas locales
Elige Outscraper para exportaciones ocasionales de listados, o considera OwnerClue para una lista corta que incluya observaciones de sitios web y revisión de contactos con fuentes. Estas sustituyen una tarea de investigación de negocios. Son malas opciones cuando el requisito es la extracción de fuentes arbitrarias, la ejecución remota de navegadores o un servicio de proxy general.
When to keep Bright Data
Mantén Bright Data si su scraper mantenido ya devuelve los campos que necesita tu aplicación y la integración de entrega es estable. Su precio basado en registros también puede ser más sencillo para esa tarea que operar tu propio parser con un endpoint de recuperación más barato.
Si usas varios productos de Bright Data, compáralos por separado. Una migración de scraper exitosa no demuestra que debas mover proxies, navegadores o conjuntos de datos comprados. Para una tarea pequeña con fuentes compatibles, consulta el nivel gratuito mensual de Web Scraper API antes de pagar por un sustituto.
Preguntas frecuentes
¿Cuál es la alternativa más cercana a Bright Data?
Para la extracción gestionada, empieza con Oxylabs o Zyte API y compara la fuente y la salida exactas. Para un endpoint configurable, considera ScrapingBee. Esta guía no afirma que una sola herramienta sustituya toda la oferta de proxies, navegadores, scrapers y conjuntos de datos de Bright Data.
¿Existe una alternativa gratuita a Bright Data?
Crawlee no tiene coste de software, pero operarlo no es gratis. Apify ofrece $5 de uso mensual y Outscraper tiene un nivel gratuito limitado para Maps. La propia Bright Data indica 5000 registros de Web Scraper API al mes gratis. Los créditos de prueba de los proveedores de API no deben contarse como acceso recurrente.
¿Por qué una solicitud más barata puede producir un registro más caro?
El sustituto puede devolver HTML en lugar de campos analizados, requerir varias solicitudes para un registro o consumir créditos adicionales por renderizado y extracción. Los campos faltantes también pueden generar trabajo de limpieza. Compara el coste total de la tarea con el número de salidas aceptadas bajo los mismos criterios.
¿Puedo mantener Bright Data y añadir una herramienta de investigación independiente?
Sí. Mantenga el paso de recopilación que funciona y luego pruebe un paso independiente de enriquecimiento o revisión con los dominios exportados. OwnerClue acepta hasta 100 filas de dominios por lote. Una los resultados revisados por dominio y conserve las fuentes. Esto es una entrega de archivos, no un reemplazo nativo del pipeline de API existente.
¿OwnerClue reemplaza un proxy o una API de navegador?
No. Está pensado para el descubrimiento de negocios locales y la investigación de sitios web y contactos de agencias. No ofrece una red de proxies general, un scraper de fuentes arbitrarias ni un entorno de navegador remoto. Para esas tareas de infraestructura, use los candidatos centrados en API.
Prueba el flujo de trabajo antes de cambiar
Reemplace el producto y la salida que realmente utiliza. Empiece con una fuente, iguale los campos y la configuración de renderizado y luego compare el costo por registro utilizable y el trabajo operativo que queda para su equipo.
Si la investigación de prospectos para agencias locales es tu prioridad, prueba una lista pequeña en OwnerClue. La prueba única incluye 20 créditos, válidos durante 14 días, sin necesidad de tarjeta.