7 Bright Data-Alternativen für Web Scraping und Geschäftsdaten (2026)
Bright Data verkauft mehrere Produkte: Proxys, Zugriffs-APIs, Scraper-APIs, Browser und Datensätze. Eine gute Alternative zu einem davon ist nicht automatisch eine Alternative zu den übrigen. Dieser Leitfaden konzentriert sich auf die Erfassung von Website- und Geschäftsdaten, mit der Web Scraper API als Preisreferenz.
Kurzantwort
Für eine verwaltete Scraping-API vergleichen Sie Oxylabs und Zyte API anhand der genauen Quelle und des Rendering-Modus, den Sie benötigen. ScrapingBee eignet sich für einen konfigurierbaren Endpunkt innerhalb einer Pipeline, die Sie bereits betreiben.
Für fertige Scraper oder eigene gehostete Jobs sehen Sie sich Apify an. Für Crawler-Code, den Sie selbst betreiben, kommt Crawlee in Betracht.
Für Listen lokaler Unternehmen eignet sich Outscraper für gelegentliche Maps-Exporte; OwnerClue eignet sich für Agenturrecherche mit Website-Beobachtungen und belegten Kontakten. Sie ersetzen kein allgemeines Proxy-Netzwerk oder eine Browser-API.
Behalten Sie Bright Data bei, wenn dessen gepflegter Scraper, Ausgabeformat oder die umfassendere Infrastruktur die Anforderung bereits erfüllt. Die Web Scraper API führt außerdem eine kostenlose monatliche Stufe mit 5000 Datensätzen auf.
Welche Bright Data -Alternative passt zu Ihrer Aufgabe?
3 kurze Fragen · optionalWie wir diese Alternativen verglichen haben
Wir haben offizielle Produktseiten, Dokumentationen und Preise geprüft – im Hinblick darauf, welche Aufgaben jedes Tool übernehmen kann, die Einstiegskosten, Limits für kostenlose Pläne oder Testphasen und was Sie neu aufbauen müssten. Die Preise wurden geprüft am October 12, 2026.
OwnerClue veröffentlicht diesen Leitfaden und ist unten aufgeführt. Dies ist ein dokumentationsbasierter Vergleich, kein Performance-Benchmark. Website-Aufnahmen identifizieren Produkte und Tarifbedingungen; offizielle Demonstrationen und der redigierte Workspace sind in ihren Bildunterschriften gekennzeichnet.
| Was wir verglichen haben | Warum es wichtig ist |
|---|---|
| Produkt und Ausgabe | Proxys, Seiteninhalte, geparste Datensätze und vorab erfasste Datensätze sind unterschiedliche Ergebnisse. |
| Genaues Ziel und Felder | Ein gepflegter Quellen-Scraper und eine Anfrage an eine eigene Domain können unterschiedliche Schemas und Tarife haben. |
| Rendering und Parsing | JavaScript, Interaktion, Extraktionsoptionen und Zielstufen verändern die Kosten für nutzbare Ausgaben. |
| Verantwortung für die Pipeline | Jemand muss weiterhin Entdeckung, Zeitplanung, Feldzuordnung und die Überwachung fehlender Daten übernehmen. |
Auf dieser Seite
Why look for alternatives to Bright Data?
Benennen Sie zunächst das Bright Data-Produkt, das Sie ersetzen möchten. Ein Proxy überträgt Datenverkehr; eine Abruf-API liefert Seiteninhalte; ein gepflegter Scraper liefert strukturierte Felder; ein Datensatz stellt eine vorhandene Sammlung bereit. Diese Ergebnisse bringen unterschiedliche Kosten und Verantwortlichkeiten mit sich.
Ein Scraper für unterstützte Quellen ist der nächste Vergleich, wenn Ihre Anwendung ein stabiles Schema für Produkte, Profile oder Einträge erwartet. Prüfen Sie die konkreten Felder, Quellenvarianten, Aktualität und Ausgabemethode. Eine günstigere HTML-Antwort ist nicht gleichwertig, wenn Ihr Team das Parsing pflegen muss.
Ein Abrufdienst ist relevant, wenn Sie die URL-Warteschlange und den Extraktionscode bereits selbst steuern. Vergleichen Sie JavaScript-Unterstützung, Anfrageeinstellungen, Antwortformate und wie optionale Extraktion die Rechnung verändert.
Ein Recherchetool für Unternehmen ist eine engere Option, wenn das Endziel eine geprüfte Liste lokaler Interessenten ist. Es kann für diese Aufgabe einen Teil der Zusammenstellung abnehmen, lässt aber die breitere Erfassungsinfrastruktur unberührt. Migrieren Sie keine Pipeline zur Preisüberwachung oder einen eigenen Browser-Workflow in ein Tool, das für lokale Leads entwickelt wurde.
The 7 Bright Data alternatives
Diese Tools übernehmen unterschiedliche Teile der Aufgabe. Jedes verwendet dasselbe Kurzformat, gefolgt von einem praktischen Anwendungsfall und einer Einschränkung, die Ihre Wahl beeinflussen könnte.
1. Oxylabs: Für eine verwaltete Scraping-API
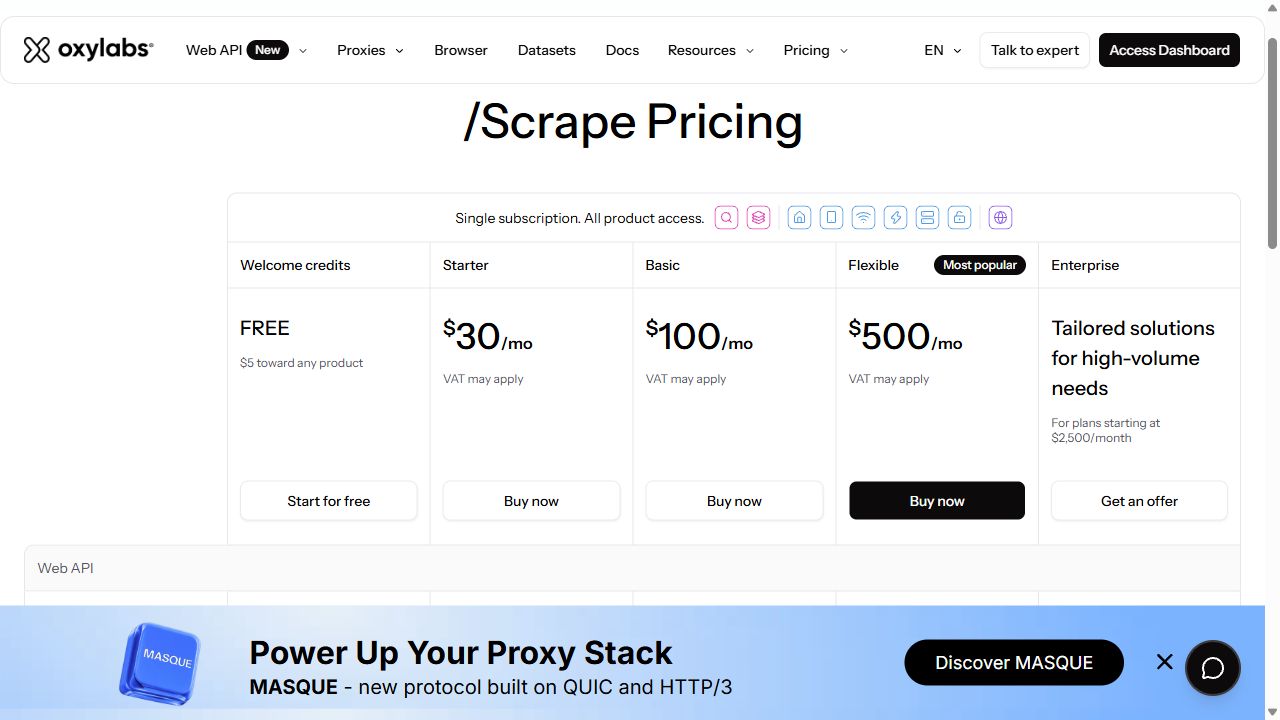
| Preis | Starter 30 $ / MonatAktuelles Web API /Scrape-Abonnement. Benutzerdefinierte Domains: 1 $ / 1000 für Nicht-JS- oder 1.50 $ / 1000 für JS-Ergebnisse zu Starter-Tarifen |
|---|---|
| Am besten geeignet für | Entwickler, die verwalteten Abruf und quellenspezifische Scraping-Endpunkte benötigen. |
| Kostenlos / Testlimits | 5 $ Willkommensguthaben für Produkte · kein wiederkehrendes Kontingent |
| Hauptfunktion | Web API /Scrape mit zielspezifischen Abruf- und Parsing-Optionen. |
| Hauptbeschränkung | Quelle, Rendering und KI-Parsing verändern den Tarif; der niedrigste beworbene Tarif ist kein universeller Preis. |
Oxylabs ist ein relevanter direkter Kandidat für den verwalteten Scraping-Teil von Bright Data. Die frühere Preis-URL der Web Scraper API leitet jetzt auf Web API /Scrape weiter, mit einem gemeinsamen Abonnement und zielspezifischen Tarifen.
Für eine benutzerdefinierte Domain listet die Starter-Tabelle separate Tarife für JavaScript und Nicht-JavaScript auf. Amazon, Google und andere Ziele haben eigene Zeilen, und KI-Parsing wird separat berechnet.
Vergleichen Sie den Endpunkt und das zurückgegebene Schema, die Ihre Pipeline tatsächlich benötigt. Verwenden Sie nicht den niedrigsten Amazon-Tarif, um eine im Browser gerenderte benutzerdefinierte Website zu schätzen. Ein Test sollte sowohl Ihre schwierigen als auch Ihre einfachen Seiten umfassen.
Ein naheliegender Kandidat für API-gestützte Erfassung. Kalkulieren Sie die genaue Quelle, den Rendering-Modus und die Parsing-Konfiguration.
2. Zyte API: Für nutzungsbasierten Website-Abruf
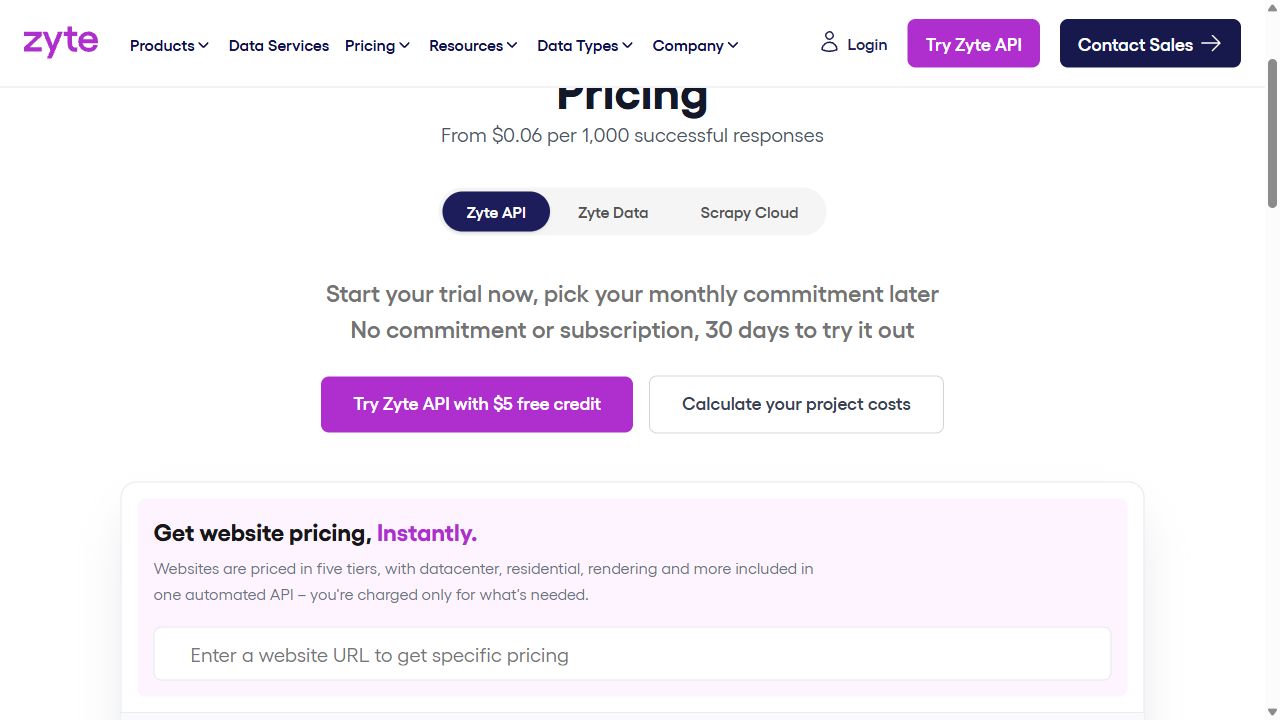
| Preis | PAYG HTTP 0.13–1.27 $ / 1000Im Browser gerendertes PAYG 1.01–16.08 $ / 1000; Website-Tarifstufe und Zusatzfunktionen beeinflussen die Kosten |
|---|---|
| Am besten geeignet für | Entwickler, die verwalteten Zugriff wünschen und ihre Crawling-Pipeline beibehalten möchten. |
| Kostenlos / Testlimits | 5 $ Guthaben · 30-tägige Evaluierung |
| Hauptfunktion | Verwalteter Abruf und Browser-Rendering mit Optionen zur automatischen Extraktion. |
| Hauptbeschränkung | HTTP-, Browser- und Extraktionskosten unterscheiden sich; der beworbene Mindestpreis setzt eine Verpflichtung voraus. |
Die Zyte API ist nützlich, wenn Sie die URL-Warteschlange und die nachgelagerte Pipeline beibehalten, aber Abruf und Rendering an einen verwalteten Dienst auslagern möchten. HTTP- und Browser-Anfragen haben unterschiedliche Preise, und die Zielwebsite bestimmt die Tarifstufe.
Das ist wichtig für einen gemischten Crawl: Ein einfacher statischer Artikel und eine schwierige gerenderte Produktseite sollten nicht dieselbe Kostenschätzung erhalten. Automatische Extraktion und andere Optionen können zusätzliche Kosten verursachen.
Der niedrigste beworbene Tarif auf der Preisseite gehört zu einem verpflichtenden Plan. Die Tabelle hier verwendet Pay-as-you-go-Bereiche, damit der Vergleich keine monatliche Verpflichtung voraussetzt, die Sie nicht gewählt haben.
Ziehen Sie ihn für eine Pipeline in Betracht, die Ihre Entwickler bereits kontrollieren. Schätzen Sie die Kosten mit repräsentativen URLs und denselben Extraktionseinstellungen.
3. ScrapingBee: Für einen konfigurierbaren Scraping-Endpunkt
| Preis | Freelance 49 $ / MonatDerzeit 250000 API-Credits und 50 gleichzeitige Anfragen angegeben |
|---|---|
| Am besten geeignet für | Entwickler, die in einer bestehenden Anwendung Seiten abrufen und ausgewählte Felder extrahieren. |
| Kostenlos / Testlimits | 1000 Test-API-Credits · keine Kreditkarte erforderlich |
| Hauptfunktion | Seitenabruf, JavaScript-Szenarien und CSS/XPath- oder KI-Extraktion. |
| Hauptbeschränkung | Eine Anfrage kann je nach Rendering-, Proxy- und Extraktionsoptionen mehrere Credits verbrauchen. |
ScrapingBee eignet sich für Entwickler, die eine URL anfordern und selbst festlegen möchten, wie sie abgerufen oder extrahiert wird. Zu den dokumentierten Optionen gehören JavaScript-Interaktionen, selektorbasierte Extraktion und KI-Extraktion.
Für einen Preis-Tracker beginnen Sie mit der einfachsten Konfiguration, die die benötigten Felder liefert. Fügen Sie Rendering oder Interaktion nur hinzu, wenn die Quelle es erfordert, und prüfen Sie die anfallenden Credits pro erfolgreich abgerufener Seite.
Der aktuelle Freelance-Tarif nennt 250000 Credits. Das ist ein Credit-Budget, keine Zusage von 250000 gerenderten Seiten oder vollständigen Produktdatensätzen. Ihre Anwendung muss weiterhin Anfragen planen, Ausgaben zuordnen und fehlende Felder überwachen.
Ein praktischer Endpunkt für eine Pipeline, die Sie selbst betreiben. Vergleichen Sie Credits pro nutzbarem Ergebnis, nicht nur die beworbenen Credits.
4. Apify: Für fertige Scraper und individuelle Cloud-Jobs
| Preis | Starter 19 $ / Monat + Nutzung19 $ vorausbezahlte Nutzung; Actor- und Plattformgebühren werden aus diesem Guthaben gedeckt |
|---|---|
| Am besten geeignet für | Teams, die unterstützte Scraper mit APIs, Zeitplänen oder eigenem Code kombinieren. |
| Kostenlos / Testlimits | 5 $ Nutzung pro Monat · keine Karte erforderlich |
| Hauptfunktion | Ein Actor-Marktplatz und eine gehostete Laufzeitumgebung für Extraktion und Automatisierung. |
| Hauptbeschränkung | Actor-Eingaben, -Ausgaben, -Preise und -Wartung unterscheiden sich je nach Entwickler. |
Apify ist ein sinnvoller Kandidat, wenn ein fertiger Actor Ihre Quelle abdeckt oder Sie eigene Logik rund um die Erfassung benötigen. Seine gehostete Laufzeit, Zeitpläne, Datensätze und APIs eignen sich für einen mehrstufigen Job mit mehr als einem Extraktionsschritt.
Für einen Händler, der eine festgelegte Gruppe von Produkt-URLs verfolgt, prüfen Sie Preis, Verfügbarkeit, Identifikatoren und Zeitstempel des ausgewählten Actors. Zwei Actors für dieselbe Website können sich in Feldern, Wartung und Abrechnung unterscheiden.
Dies ist eine Entscheidung für Plattform und Actor, kein direkter Proxy-Ersatz. Rechnen Sie die Ereignis- oder Nutzungsgebühren des Actors und jeden zusätzlichen Plattformverbrauch ein. Führen Sie einen kleinen Testlauf durch, bevor Sie die monatlichen Pipeline-Kosten schätzen.
Wählen Sie es, wenn ein verifizierter Actor oder ein eigenes gehostetes Programm ausschlaggebend ist. Vergleichen Sie seine vollständige Ausgabe und Abrechnung mit dem aktuellen Bright Data Scraper.
5. Crawlee: Für einen Crawler, den Ihr Team selbst betreibt
| Preis | Kostenlose Open-Source-SoftwareHosting, Proxys, Speicher und Engineering verursachen zusätzliche Kosten |
|---|---|
| Am besten geeignet für | Entwickler, die eigenen Extraktionscode erstellen und betreiben. |
| Kostenlos / Testlimits | Die Bibliothek hat keine Software-Abonnementgebühr |
| Hauptfunktion | Open-Source-Crawling mit JavaScript und Python, mit Infrastruktur, die Sie selbst verwalten. |
| Hauptbeschränkung | Ihr Team verantwortet Ausführung, Überwachung, Infrastruktur und Wartung. |
Crawlee ist die Option, wenn Kontrolle über den Extraktionscode wichtiger ist als der Kauf eines gepflegten Datendienstes. Es ist eine Open-Source-Crawling-Bibliothek von Apify mit Einstiegspunkten für JavaScript und Python.
Für ein Team, das eine sich ändernde Gruppe interner Recherchequellen erfasst, kann es nützlich sein, die Anfragewarteschlange und den Parsing-Code selbst zu besitzen. Dieses Team verantwortet dann aber auch Ausführung, Speicherung, Zeitpläne, Überwachung und Wartung, wenn sich eine Website ändert.
Crawlee enthält kein Proxy-Netzwerk und keinen fertigen Ersatz für die Quellenschemata von Bright Data. Sie können darunter weiterhin einen verwalteten Abruf- oder Proxy-Dienst nutzen. Kalkulieren Sie Infrastruktur und Engineering ein, bevor Sie das Fehlen einer Softwaregebühr als niedrigere Gesamtkosten betrachten.
Ziehen Sie es in Betracht, wenn Ihr Team den Crawler betreiben kann. Es ist eine Infrastrukturentscheidung, kein kostenloses Äquivalent zu einem verwalteten Datenfeed.
6. Outscraper: Für gelegentliche Google-Maps-Exporte
| Preis | 3 $ / 1000 Maps-DatensätzeNutzung von 501 bis 100000 Unternehmen; danach 1 $ / 1000 oberhalb dieser Stufe |
|---|---|
| Am besten geeignet für | Teams, die Maps-Datensätze ohne wiederkehrendes Abonnement wünschen. |
| Kostenlos / Testlimits | Erste 500 Maps-Unternehmen; Stufen werden alle 30 Tage zurückgesetzt |
| Hauptfunktion | Google-Maps-Unternehmensexporte mit optionaler Anreicherung von Website-Kontakten. |
| Hauptbeschränkung | Basis-Maps-Extraktion und zusätzliche Anreicherung müssen separat kalkuliert werden. |
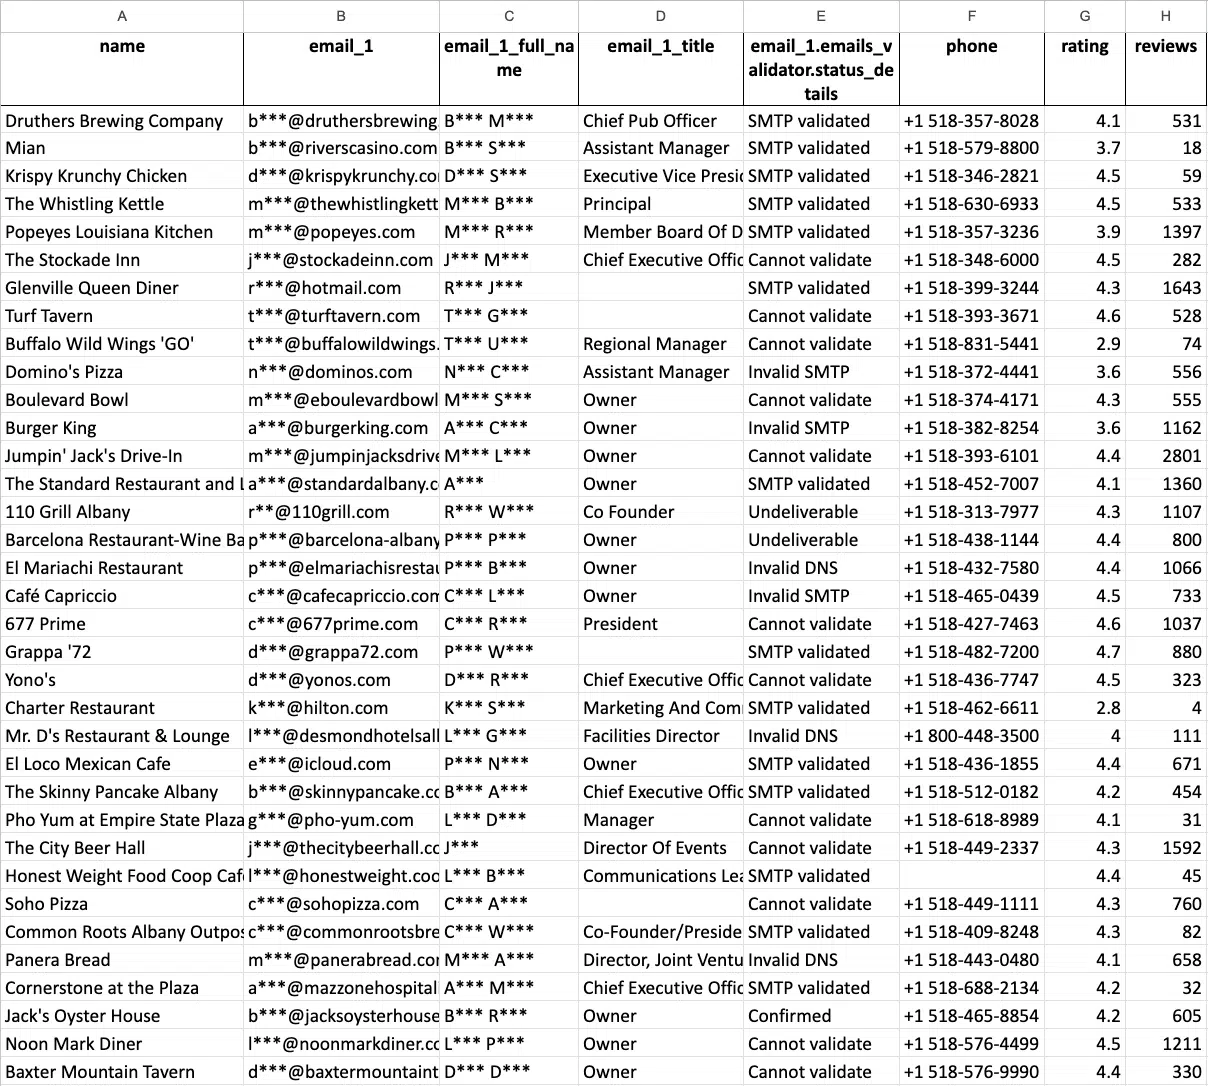
Outscraper ist eine spezialisierte Option, wenn der Bright-Data-Job, den Sie ersetzen müssen, ein Google-Maps-Unternehmensexport ist. Es liefert Listing-Felder und bietet separate Dienste zur Anreicherung mit Website-Kontaktdaten.
Für eine gelegentliche Gebietsliste kann eine nutzungsbasierte Extraktion einfacher zu budgetieren sein als der Unterhalt einer eigenen Erfassungspipeline. Prüfen Sie vor dem Quellenwechsel dieselben Standorte, Listing-Felder und Duplikate.
Der Basispreis für Maps enthält nicht jede Anreicherung, die Sie möglicherweise benötigen. Vergleichen Sie Extraktion plus Kontaktrecherche und bewahren Sie die Listing-Identifikatoren für spätere Verknüpfungen auf. Diese Option ersetzt nicht die allgemeinen Website-APIs, Browser oder Proxy-Infrastruktur von Bright Data.
Ein fokussierter Kandidat für eine Maps-Liste. Gleichen Sie die erforderlichen Felder und Anreicherungsdienste ab, bevor Sie den Preis pro Datensatz vergleichen.
7. OwnerClue: Für die Recherche lokaler Interessenten durch Agenturen
| Preis | Starter 35 $ / Monat10000 Credits, gemeinsam genutzt über unterstützte Vorgänge |
|---|---|
| Am besten geeignet für | Webdesign-, Local-SEO- und Marketingagenturen, die lokale Interessenten recherchieren. |
| Kostenlos / Testlimits | Einmalige 20-Credit-Testversion · 14 Tage · keine Karte erforderlich |
| Hauptfunktion | Lokale Marktsuche, Website-Recherche, Opportunity-Hinweise und belegte Kontakte in einem einzigen Prospecting-Workspace. |
| Hauptbeschränkung | Öffentliche Kontakte und Inhaber können fehlen. Die Verifizierung der Mailbox-Zustellung ist davon getrennt. |
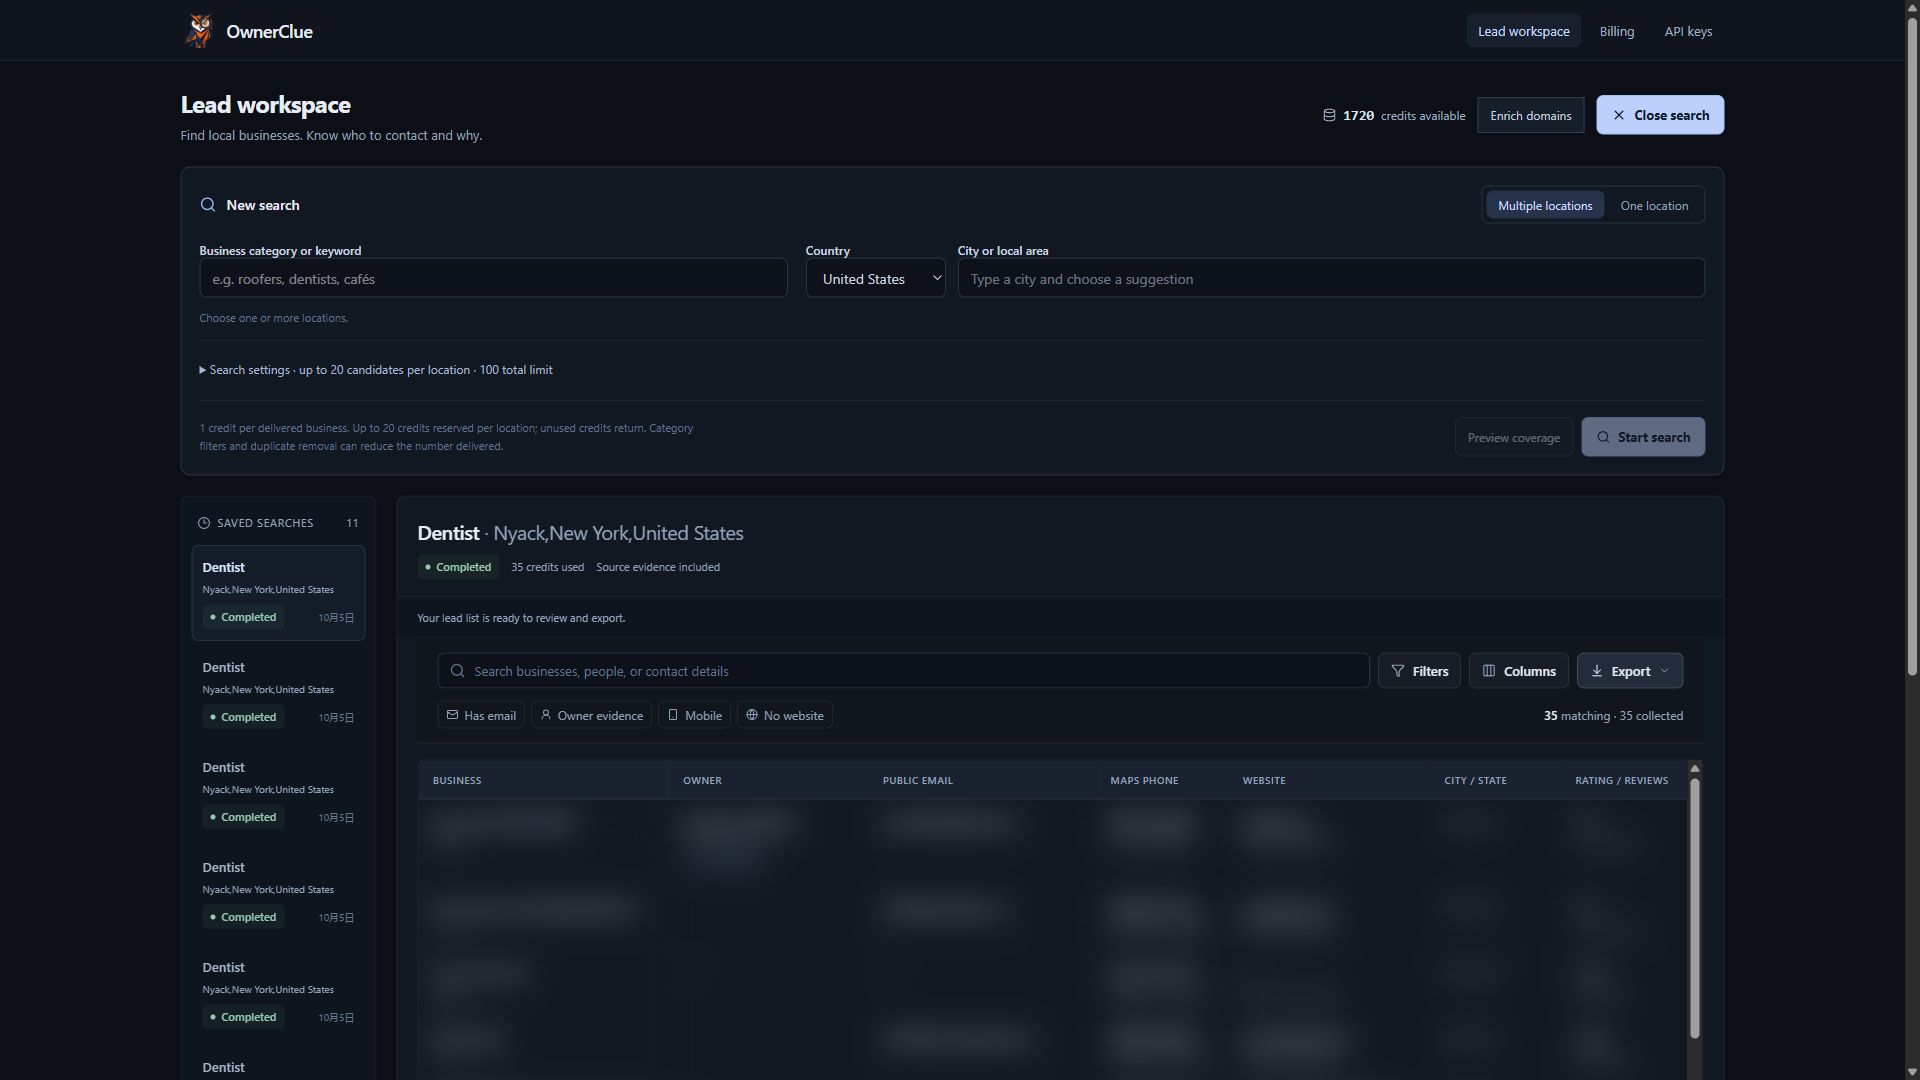
OwnerClue passt zum Agentur-Job, nachdem entschieden wurde, welcher lokale Markt recherchiert werden soll. Es kombiniert Branchen- und Standortsuche, Website-Beobachtungen, quellenbasierte Kontaktprüfung und CSV-Export rund um einen Unternehmensdatensatz.
Für eine SEO- oder Webdesign-Agentur ist das nützliche Ergebnis eine Shortlist mit Kontext: die gelistete Website, was geprüft werden konnte, verfügbare Kontaktwege und belegte Hinweise auf Eigentümer/Gründer. Das kann den Aufwand reduzieren, die Recherche aus separaten Dateien zusammenzustellen. Keine gelistete Website oder kein gefundener Buchungslink ist ein Hinweis zum Nachforschen, kein Nachweis von Nachfrage.
Bright Data kann Unternehmensdatensätze bereits erfassen. Der Grund, warum OwnerClue hier steht, ist der Recherche-Workflow der Agentur, nicht exklusiver Zugang zu diesen Daten. Es ersetzt keine APIs für beliebige Quellen, Proxys oder Browser-Automatisierung. Kontakte können fehlen, und CSV-Übergaben bieten keine native CRM-Synchronisierung oder Verifizierung der Zustellung ins Postfach.
Ziehen Sie es in Betracht, wenn das Endprodukt eine Prospect-Shortlist für eine Agentur ist. Behalten Sie einen API-Anbieter, wenn Ihre Anwendung allgemeine Web-Datenerfassung benötigt.
Preise und kostenlose Limits im direkten Vergleich
USD-Beträge unterscheiden zwischen monatlicher Abrechnung, Jahresäquivalenten und nutzungsbasierten Gebühren. Kostenlose Pläne und Testangebote erscheinen in jeder Zeile separat.
| Tool | Kostenloser Zugang / Testzugang | Kostenpflichtiger Einstiegspunkt | Hauptfunktion |
|---|---|---|---|
| Bright Data | 5000 Datensätze / Monat für die Web Scraper API aufgeführt | $1.50 / 1000 DatensätzeNutzungsbasierte Preise der Web Scraper API | Gepflegte Scraper-APIs mit strukturierter Auslieferung als JSON, NDJSON oder CSV. |
| Oxylabs | 5 $ Willkommensguthaben für Produkte · kein wiederkehrendes Kontingent | Starter 30 $ / MonatAktuelles Web API /Scrape-Abonnement. Benutzerdefinierte Domains: 1 $ / 1000 für Nicht-JS- oder 1.50 $ / 1000 für JS-Ergebnisse zu Starter-Tarifen | Web API /Scrape mit zielspezifischen Abruf- und Parsing-Optionen. |
| Zyte API | 5 $ Guthaben · 30-tägige Evaluierung | PAYG HTTP 0.13–1.27 $ / 1000Im Browser gerendertes PAYG 1.01–16.08 $ / 1000; Website-Tarifstufe und Zusatzfunktionen beeinflussen die Kosten | Verwalteter Abruf und Browser-Rendering mit Optionen zur automatischen Extraktion. |
| ScrapingBee | 1000 Test-API-Credits · keine Kreditkarte erforderlich | Freelance 49 $ / MonatDerzeit 250000 API-Credits und 50 gleichzeitige Anfragen angegeben | Seitenabruf, JavaScript-Szenarien und CSS/XPath- oder KI-Extraktion. |
| Apify | 5 $ Nutzung pro Monat · keine Karte erforderlich | Starter 19 $ / Monat + Nutzung19 $ vorausbezahlte Nutzung; Actor- und Plattformgebühren werden aus diesem Guthaben gedeckt | Ein Actor-Marktplatz und eine gehostete Laufzeitumgebung für Extraktion und Automatisierung. |
| Crawlee | Die Bibliothek hat keine Software-Abonnementgebühr | Kostenlose Open-Source-SoftwareHosting, Proxys, Speicher und Engineering verursachen zusätzliche Kosten | Open-Source-Crawling mit JavaScript und Python, mit Infrastruktur, die Sie selbst verwalten. |
| Outscraper | Erste 500 Maps-Unternehmen; Stufen werden alle 30 Tage zurückgesetzt | 3 $ / 1000 Maps-DatensätzeNutzung von 501 bis 100000 Unternehmen; danach 1 $ / 1000 oberhalb dieser Stufe | Google-Maps-Unternehmensexporte mit optionaler Anreicherung von Website-Kontakten. |
| OwnerClue | Einmalige 20-Credit-Testversion · 14 Tage · keine Karte erforderlich | Starter 35 $ / Monat10000 Credits, gemeinsam genutzt über unterstützte Vorgänge | Lokale Marktsuche, Website-Recherche, Opportunity-Hinweise und belegte Kontakte in einem einzigen Prospecting-Workspace. |
Offizielle Quellen sind unter jedem Produkt verlinkt. Die Testphase des Herausgebers ist einmalig. Kontingente für Credits, Seiten, URLs, Seats und Datensätze messen unterschiedliche Dinge; bestätigen Sie die gewählte Konfiguration vor dem Kauf.
Kalkulieren Sie die Ausgabe, die Ihre Anwendung nutzen kann. Die Bright Data Web Scraper API listet $1.50 pro 1000 gelieferten Datensätzen im Pay-as-you-go-Modell. Die kostenlose Stufe mit fünftausend Datensätzen gehört zu diesem Produkt; Proxy-, Browser- und Dataset-Angebote haben eigene Bedingungen.
Die Alternativen verwenden unterschiedliche Einheiten. Zyte berechnet HTTP- und Browser-Anfragen nach Website-Stufe. ScrapingBee verkauft Credits, die sich durch Einstellungen vervielfachen können. Oxylabs berechnet nach Ziel und Konfiguration, mit separaten Preisen für KI-Parsing. Ein Apify-Actor kann nach Ereignis oder Plattformnutzung abrechnen. Dies sind keine austauschbaren Zeilen von “records.”
Verwenden Sie eine repräsentative Stichprobe mit den Seitenlayouts und Rendering-Anforderungen, die den echten Job schwierig machen. Zählen Sie nur Ausgaben mit den erforderlichen Feldern und addieren Sie dann Parsing-, Anreicherungs-, Speicher- und Betriebsaufwand hinzu, den die Alternative Ihnen überlässt. Behalten Sie auf beiden Seiten dieselben Abnahmekriterien bei.
Kosten pro nutzbarem Datensatz = Gesamtkosten für Erfassung und Verarbeitung ÷ Datensätze, die die Anforderungen erfüllen
How to replace your Bright Data workflow
Der sicherste Pilot ersetzt zuerst eine Quelle oder einen Recherche-Job. Lassen Sie andere Bright-Data-Dienste bestehen, bis deren Ersatz nachgewiesen ist.
| Aktuelle Ausgabe | Ersatzpfad | Pilot-Prüfung | Aufwand, der weiterhin bei Ihnen liegt |
|---|---|---|---|
| Strukturierte Quelldatensätze | Oxylabs, Zyte-Extraktion oder ein Apify Actor | Gleiche URLs, erforderliche Felder, Identifikatoren, Rendering und Aktualität | Schema-Mapping, Übergabe der Auslieferung, Prüfung fehlender Felder |
| Seiteninhalt für Ihren Parser | Zyte API, ScrapingBee oder Crawlee + Retrieval | HTML-/gerendertes Ausgabeformat und Kosten für erfolgreichen Abruf | URL-Erkennung, Parsing, Zeitpläne und Monitoring |
| Lokale Interessenten-Shortlist | Outscraper oder OwnerClue | Gleiche Branche/Gebiet und erforderlicher Kontaktkontext | Prüfung, Ausschlüsse, CSV-Import und etwaiger Versand-Workflow |
1. Einen gepflegten Scraper ersetzen
Frieren Sie eine Stichprobe von Quell-URLs und erforderlichen Ausgabefeldern ein. Führen Sie den Kandidaten mit gleichwertigen Rendering- und Extraktionseinstellungen aus. Vergleichen Sie Identifikatoren, Varianten, Zeitstempel, fehlende Werte und Anzahl der gelieferten Datensätze. Passen Sie die API- oder Webhook-Übergabe an und führen Sie dann einen geplanten Zyklus aus, bevor Sie das restliche Volumen dorthin leiten.
2. Retrieval ändern, ohne die gesamte Pipeline zu ändern
Behalten Sie Ihre Discovery-Warteschlange und den nachgelagerten Parser. Ersetzen Sie die Anforderungsebene für eine kleine URL-Menge und prüfen Sie den zurückgegebenen Inhalt vor dem Parsing. Bestätigen Sie, welche Antworten berechnet werden und welche Optionen zusätzliche Kosten verursachen. Stellen Sie das Retry- und Monitoring-Verhalten bei Bedarf in Ihrer Anwendung wieder her. Ein Retrieval-Endpunkt ist kein vollständiger Scheduler und kein Data-Quality-System.
3. Eine Rechercheaufgabe zu lokalen Unternehmen vereinfachen
Definieren Sie die Branche, das Gebiet und die Kontaktfelder, die Sie tatsächlich benötigen. Vergleichen Sie einen Maps-Export über Outscraper mit einer Agentur-Recherche-Shortlist in OwnerClue. Prüfen Sie Website-Zuordnungen und Kontaktquellen, behalten Sie die ursprünglichen Identifikatoren bei und exportieren Sie die akzeptierten Unternehmen. Behalten Sie Bright Data für unabhängige Produkt-, Social- oder benutzerdefinierte Quellenerfassung.
- Erforderliche Felder definieren
- Abgeglichene Quell-URLs ausführen
- Ausgabe zuordnen und prüfen
- Eine geplante Quelle verschieben
Welche Alternative sollten Sie wählen?
Für Entwickler, die verwaltete Extraktion kaufen
Vergleichen Sie Oxylabs mit dem genauen Quell-Endpunkt und den Parsing-Anforderungen. Vergleichen Sie Zyte, wenn zielgruppenspezifisches Retrieval zu Ihrer bestehenden Pipeline passt. Wählen Sie ScrapingBee, wenn konfigurierbare Abruf- und Extraktionsparameter zur Anwendung passen. Entscheiden Sie anhand der tatsächlichen Stichprobenergebnisse und Kosten statt anhand des niedrigsten veröffentlichten Tarifs.
Für Teams, die mehr Kontrolle über den Code wünschen
Verwenden Sie Apify für einen verifizierten Actor oder ein benutzerdefiniertes gehostetes Programm. Wählen Sie Crawlee, wenn der Betrieb von Code und Infrastruktur eine bewusste Teamentscheidung ist. Sie können eine Crawler-Bibliothek mit verwaltetem Retrieval kombinieren; diese Tools schließen sich nicht gegenseitig aus.
Für Agenturen, die lokale Vertriebslisten vorbereiten
Wählen Sie Outscraper für gelegentliche Listing-Exporte oder erwägen Sie OwnerClue für eine Shortlist mit Website-Beobachtungen und quellenbasierter Kontaktprüfung. Diese ersetzen eine Rechercheaufgabe zu Unternehmen. Sie sind eine schlechte Wahl, wenn die Anforderung die Extraktion beliebiger Quellen, die Ausführung eines Remote-Browsers oder ein allgemeiner Proxy-Dienst ist.
When to keep Bright Data
Behalten Sie Bright Data, wenn sein gepflegter Scraper bereits die Felder zurückgibt, die Ihre Anwendung benötigt, und die Auslieferungsintegration stabil ist. Die datensatzbasierte Preisgestaltung kann für diese Aufgabe auch einfacher sein als der Betrieb eines eigenen Parsers um einen günstigeren Retrieval-Endpunkt herum.
Wenn Sie mehrere Bright-Data-Produkte nutzen, vergleichen Sie diese getrennt. Eine erfolgreiche Scraper-Migration belegt nicht, dass Sie Proxys, Browser oder gekaufte Datensätze verschieben sollten. Prüfen Sie für eine kleine Aufgabe mit unterstützten Quellen das monatliche kostenlose Kontingent der Web Scraper API, bevor Sie für einen Ersatz zahlen.
Häufig gestellte Fragen
Welche ist die nächste Alternative zu Bright Data?
Beginnen Sie bei verwalteter Extraktion mit Oxylabs oder Zyte API und vergleichen Sie die genaue Quelle und Ausgabe. Für einen konfigurierbaren Endpunkt ziehen Sie ScrapingBee in Betracht. Dieser Leitfaden behauptet nicht, dass ein einziges Tool das gesamte Proxy-, Browser-, Scraper- und Datensatzangebot von Bright Data ersetzt.
Gibt es eine kostenlose Alternative zu Bright Data?
Crawlee hat keine Softwaregebühr, aber der Betrieb ist nicht kostenlos. Apify bietet $5 monatliche Nutzung und Outscraper hat ein begrenztes kostenloses Maps-Kontingent. Bright Data selbst nennt 5000 Web-Scraper-API-Datensätze pro Monat kostenlos. Testguthaben von API-Anbietern sollten nicht als dauerhafter Zugang gezählt werden.
Warum kann eine günstigere Anfrage trotzdem einen teureren Datensatz erzeugen?
Der Ersatz kann HTML statt geparster Felder zurückgeben, mehrere Anfragen für einen Datensatz erfordern oder zusätzliche Credits für Rendering und Extraktion verbrauchen. Fehlende Felder können zudem Aufräumarbeiten verursachen. Vergleichen Sie die Gesamtkosten der Aufgabe mit der Anzahl akzeptierter Ausgaben unter denselben Kriterien.
Kann ich Bright Data behalten und ein separates Recherche-Tool hinzufügen?
Ja. Behalten Sie den Erfassungsschritt, der funktioniert, und testen Sie dann einen separaten Anreicherungs- oder Prüfschritt mit exportierten Domains. OwnerClue akzeptiert bis zu 100 Domain-Zeilen pro Batch. Führen Sie geprüfte Ergebnisse nach Domain zusammen und bewahren Sie die Quellen auf. Dies ist eine Dateiübergabe, kein nativer Ersatz für die bestehende API-Pipeline.
Ersetzt OwnerClue einen Proxy oder eine Browser-API?
Nein. Es dient der Entdeckung lokaler Unternehmen und der Recherche von Agentur-Websites und Kontakten. Es bietet kein allgemeines Proxy-Netzwerk, keinen Scraper für beliebige Quellen und keine Remote-Browser-Laufzeit. Für diese Infrastrukturaufgaben sollten Sie die API-fokussierten Kandidaten verwenden.
Testen Sie den Workflow, bevor Sie wechseln
Ersetzen Sie das Produkt und die Ausgabe, die Sie tatsächlich nutzen. Beginnen Sie mit einer Quelle, gleichen Sie Felder und Rendering-Einstellungen ab und vergleichen Sie dann die Kosten pro nutzbarem Datensatz und den verbleibenden Betriebsaufwand für Ihr Team.
Wenn die Recherche lokaler Agentur-Potenzialkunden für Sie Priorität hat, testen Sie eine kleine Liste in OwnerClue. Die einmalige Testphase umfasst 20 Credits, gültig für 14 Tage, ohne Kreditkarte.